Il capitolo tredici si è chiuso promettendo che il Transformer avrebbe risolto i limiti di Word2Vec: lo stesso vettore per la stessa parola, indipendentemente dalle sue sfumature di significato, e nessuna sensibilità all’ordine delle parole nella frase. Ma non era la prima promessa lasciata in sospeso: già nel capitolo dieci avevamo ereditato il limite fondamentale delle RNN, la lettura sequenziale che fa sfaldare le dipendenze lontane per il vanishing gradient. Una singola architettura risolve entrambi i problemi insieme, ed è il momento di aprirla, pezzo per pezzo, per il resto della Serie 4. Cominciamo da dove è nata.
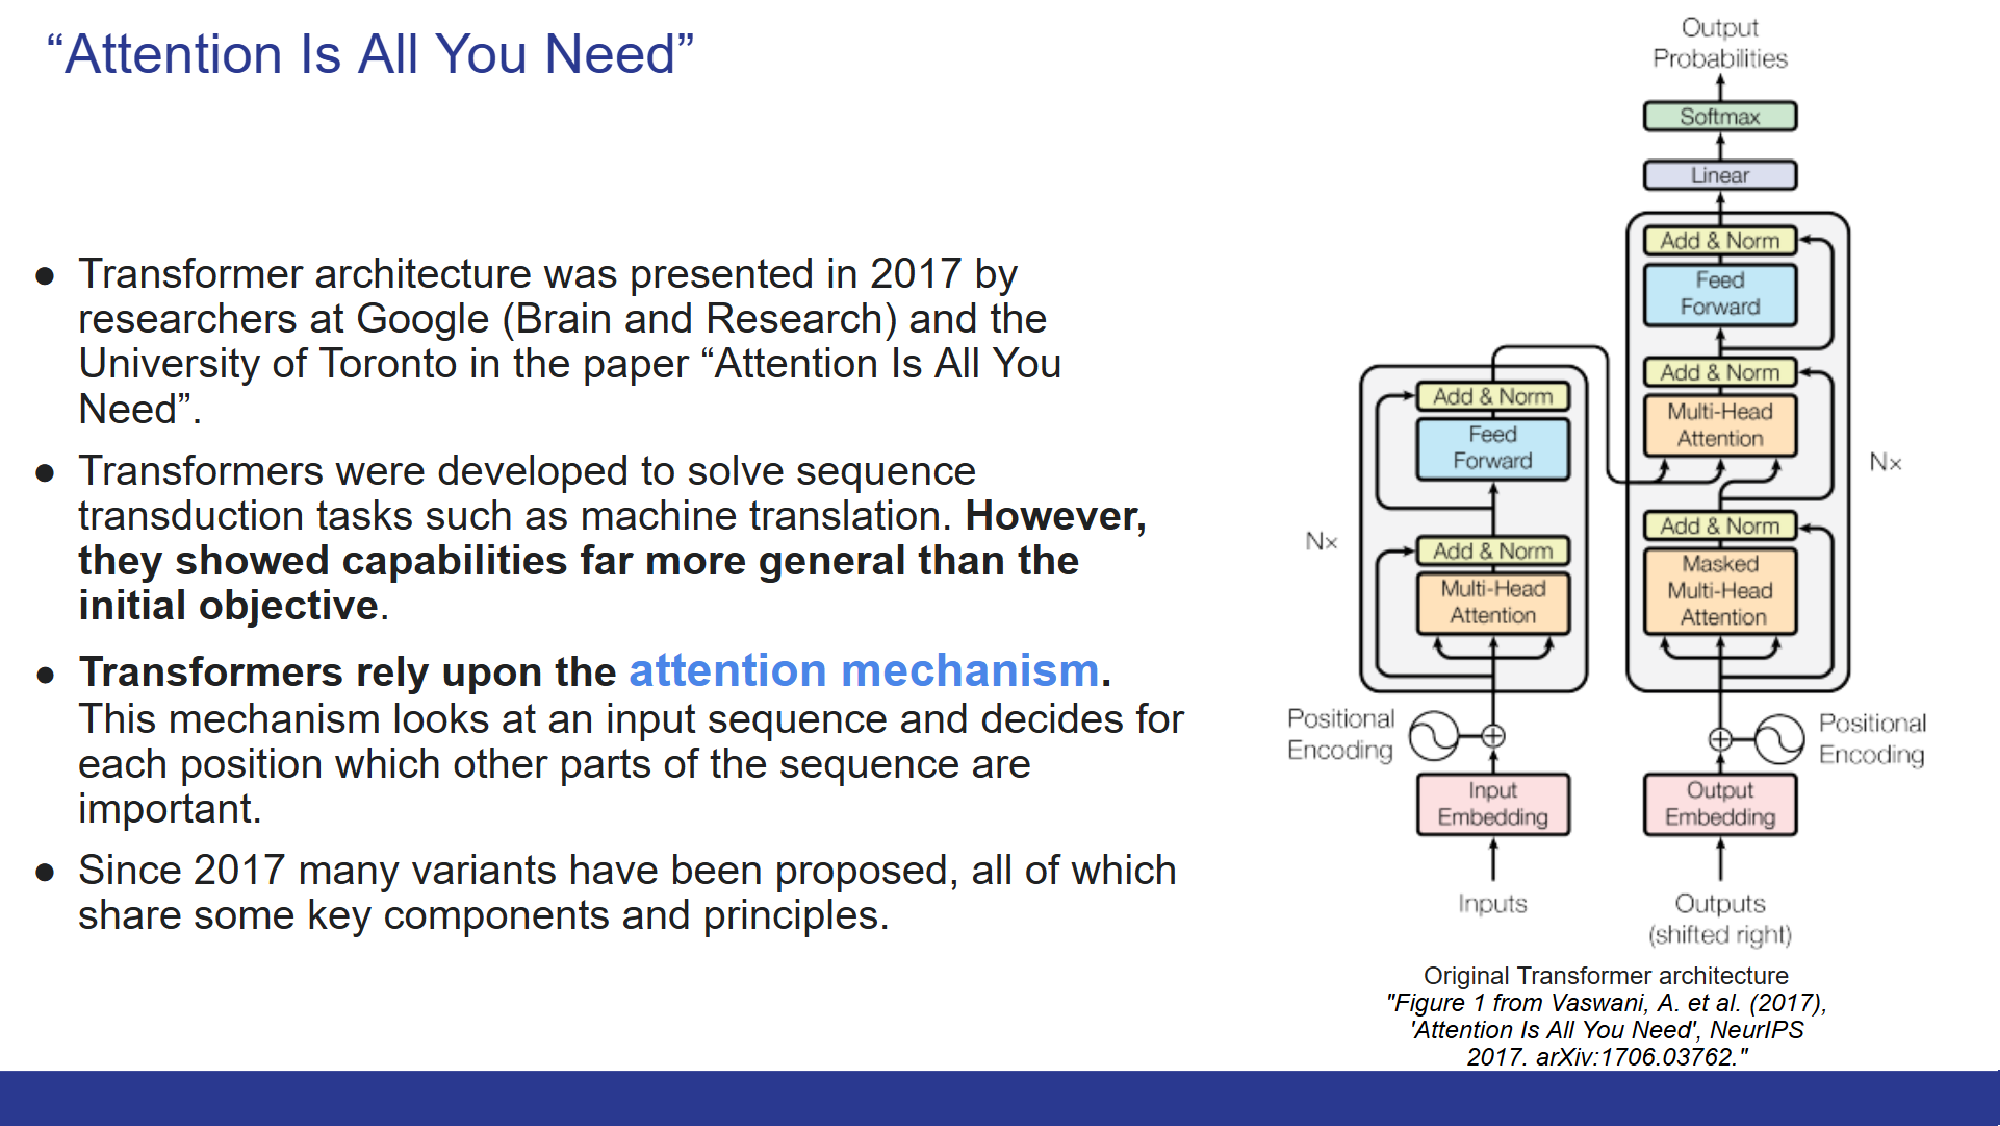
Nel 2017 un gruppo di ricercatori di Google, tra Brain e Research, e dell’Università di Toronto pubblica un paper con un titolo che è già un manifesto: “Attention Is All You Need”. Il problema che volevano risolvere era la traduzione automatica, un caso particolare di quello che in letteratura si chiama sequence transduction: prendere una sequenza in una lingua e trasformarla nella sequenza corrispondente in un’altra. Nessuno, in quel momento, stava pensando a un chatbot. Eppure quell’architettura si è rivelata molto più generale dell’obiettivo iniziale, al punto da diventare, nel giro di pochi anni, l’architettura su cui è costruito praticamente ogni large language model oggi in uso.
Il cuore dell’idea si chiama attenzione, ed è un cambio di paradigma rispetto a come lavora una RNN. Una rete ricorrente legge una parola alla volta, portandosi dietro una sintesi di quello che ha già letto. Il Transformer, invece, guarda tutta la sequenza in una sola volta e, per ogni parola, calcola direttamente quanto ciascuna delle altre le sia rilevante. Se “francese” dipende da “Parigi” dieci parole prima, l’attenzione le collega con un solo passaggio, non con una catena di dieci stati nascosti da risalire.
C’è un modo utile per visualizzare come è fatta, nel suo complesso, questa architettura. L’input è sempre una matrice, solo che invece di essere la matrice di un’immagine appiattita, è una matrice in cui ogni riga è una parola, o meglio un token, come vedremo nel prossimo capitolo, e contiene la sua rappresentazione vettoriale, l’embedding dei capitoli undici e dodici: ogni colonna è una delle dimensioni di quel vettore. Quella matrice attraversa poi una pila di blocchi identici, decine nei modelli moderni, e ne esce ogni volta con le stesse dimensioni con cui è entrata. La forma a clessidra dei capitoli dieci e dodici, però, non scompare del tutto: la ritroviamo dentro ogni blocco, nello strato dell’attenzione. Questo strato è suddiviso in tante teste che lavorano in parallelo, e ciascuna proietta i vettori in uno spazio più piccolo, nel paper originale da 512 a 64 dimensioni, prima che i risultati vengano ricomposti e riportati alle dimensioni di partenza. Lo strato feedforward che segue fa invece l’opposto: prima allarga, poi restringe. Vedremo entrambi da vicino nei prossimi capitoli.
Ed è proprio in questo che sta il senso letterale del titolo del paper. A differenza di una CNN, qui la convoluzione sparisce del tutto; e a differenza di una RNN, le sequenze di testo vengono gestite senza alcun meccanismo ricorrente. Resta solo l’attenzione, a fare tutto il lavoro che prima veniva affidato a filtri convoluzionali o a stati nascosti che si tramandano nel tempo: attention is all you need, l’attenzione è tutto ciò che serve.
Guardare tutte le posizioni insieme ha una seconda conseguenza, meno vistosa ma altrettanto decisiva: è un calcolo che si parallelizza su una GPU in un modo che una RNN, intrinsecamente sequenziale, non può replicare. È proprio questa parallelizzazione ad aver reso possibile addestrare modelli su quantità di testo che, con un’architettura ricorrente, sarebbero rimaste fuori portata.
Torniamo ai due limiti di Word2Vec. Il primo era l’ordine: una somma di vettori di contesto è commutativa, non porta con sé nessuna informazione di posizione. Il Transformer eredita lo stesso problema alla radice, e lo risolve aggiungendo esplicitamente un’informazione di posizione a ogni parola, la cosiddetta codifica posizionale, che riprenderemo più avanti. Il secondo limite era che a una stessa parola, intesa come sequenza di lettere, l’algoritmo di embedding assegna sempre lo stesso, unico vettore, indipendentemente dal significato che questa assume in base al contesto. “Bank” restava sempre lo stesso vettore, che si parlasse di banche o di sponde di un fiume. Con l’attenzione, ogni occorrenza di una parola pesa dinamicamente le parole che la circondano, così la sua rappresentazione cambia frase per frase.
Un’ultima precisazione: il Transformer del 2017 aveva due metà distinte, un encoder e un decoder. I moderni large language model tengono solo la seconda metà: sono modelli decoder-only. Un avvertimento, però: nell’ambito dei Transformer, “decoder” non indica l’omonimo blocco visto nell’autoencoder del capitolo dieci, la metà che riallarga lo spazio latente fino alle dimensioni originali. Nel Transformer i blocchi non si restringono né si riallargano: la parola “decoder” indica soltanto quale dei due blocchi del Transformer originale viene tenuto, quello che genera il testo una parola alla volta guardando solo le parole che la precedono.
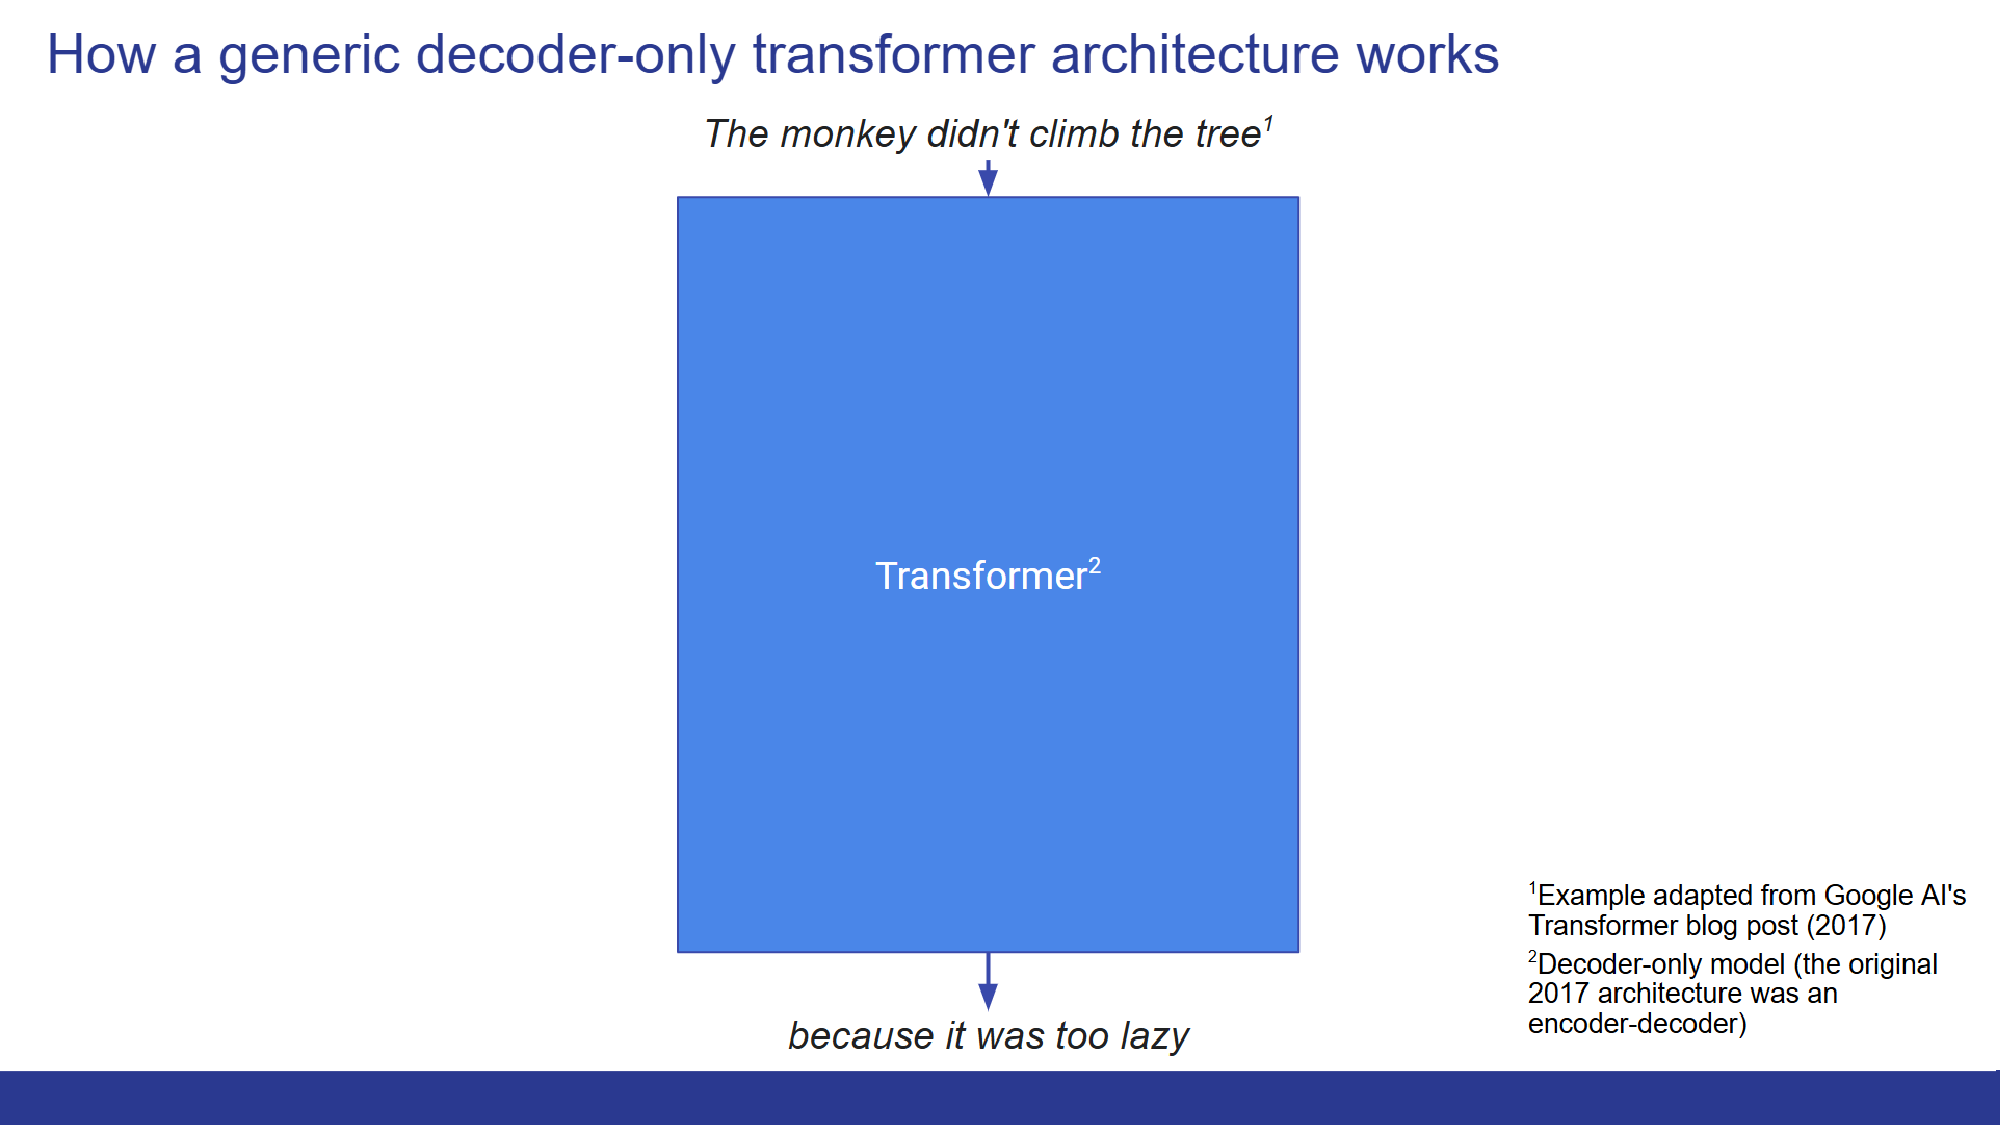
Nei prossimi capitoli analizzeremo come è fatto un Transformer decoder-only, layer per layer. Lo faremo immaginando di dare in input a questa architettura la frase “The monkey didn’t climb the tree”, adattata da un esempio del post con cui Google presentò il Transformer nel 2017, e scopriremo in che modo il modello produce in output “because it was too lazy”.