Il capitolo 12 si chiudeva promettendo proprietà e limiti inaspettati. Cominciamo dai limiti, perché Word2Vec, per quanto elegante, porta con sé due difetti strutturali.
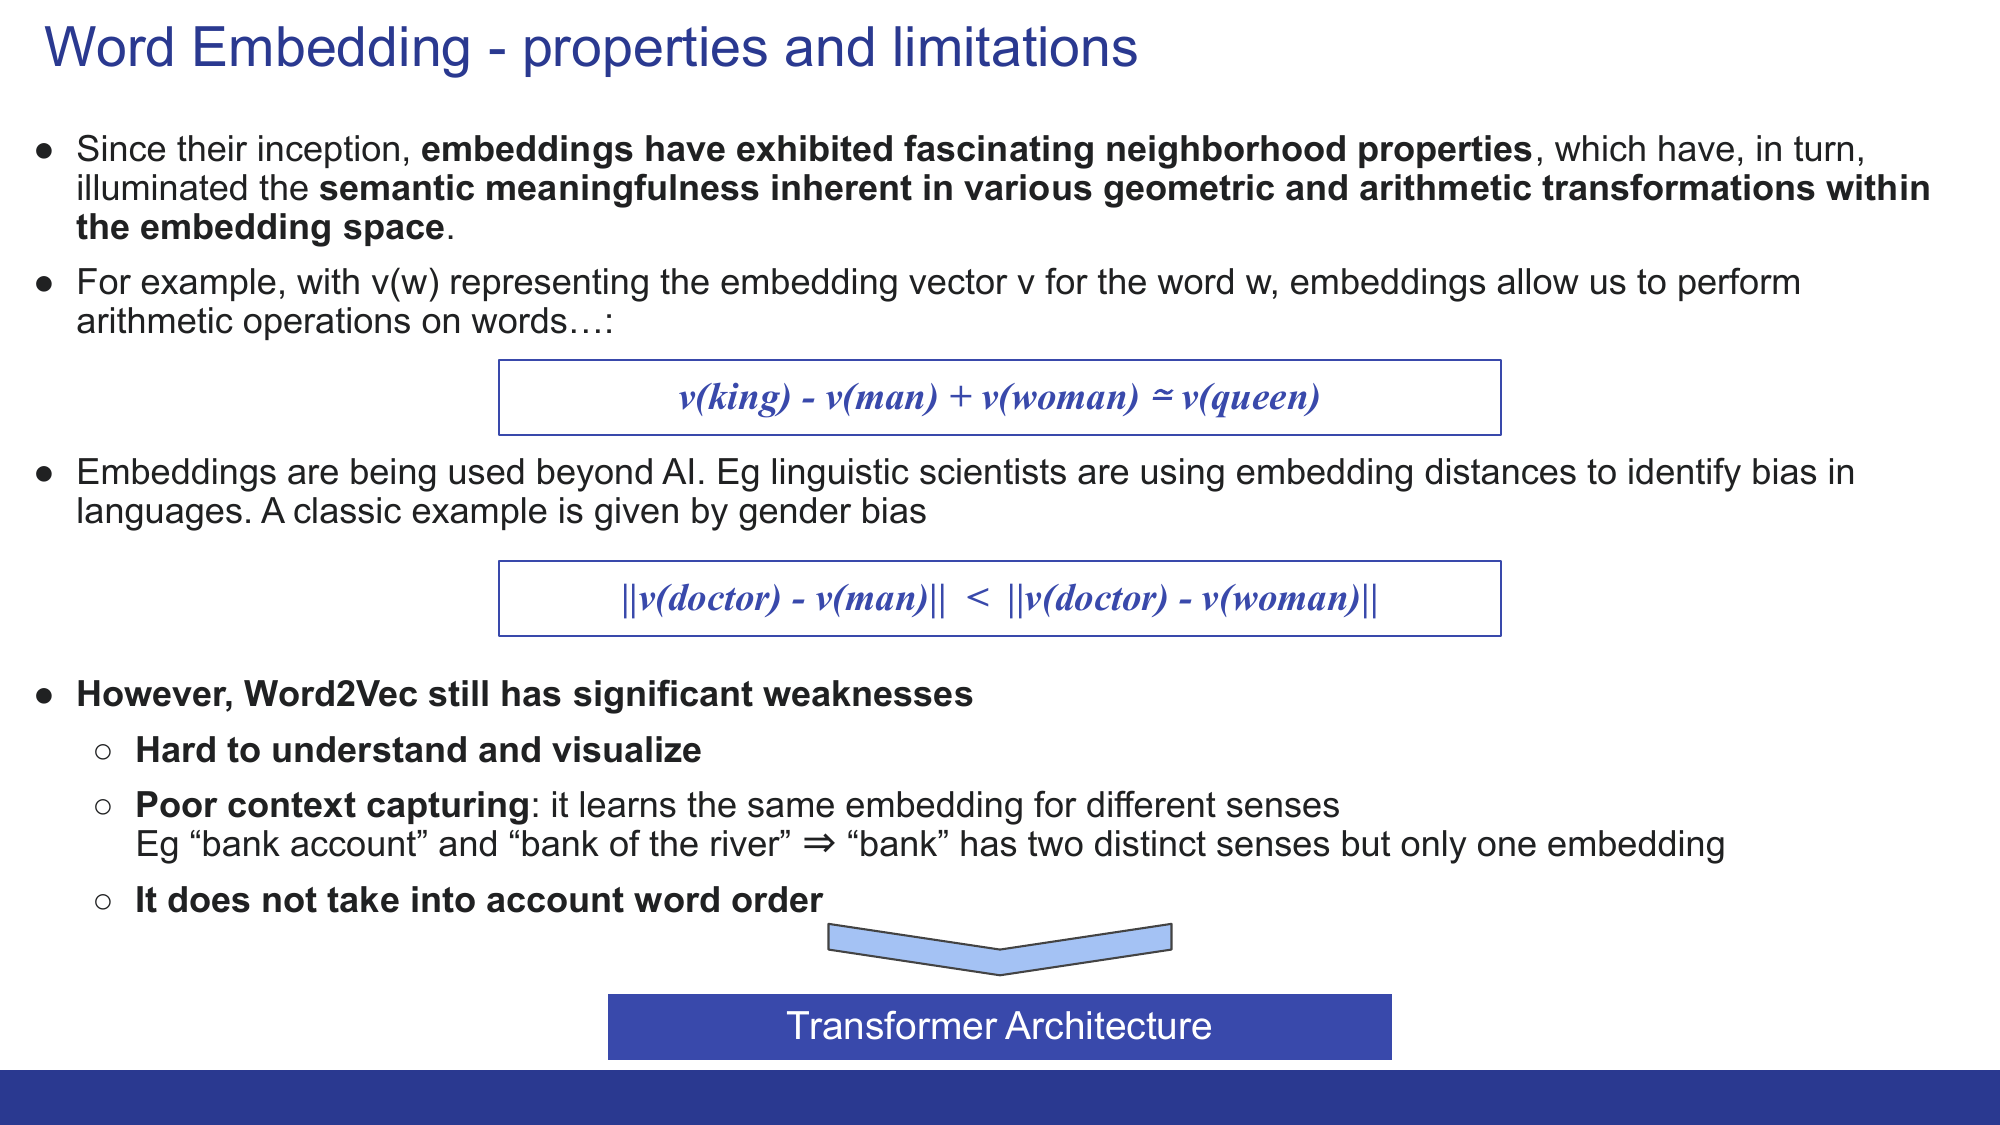
Il primo è che assegna un solo embedding per parola, non per significato. Prendi la parola inglese “bank”: può voler dire istituto finanziario, oppure sponda di un fiume, due significati completamente distinti. Word2Vec però non lo sa: guarda tutte le frasi in cui compare “bank”, le mescola tutte insieme e ne ricava un unico vettore che è una specie di media tra i due sensi, incapace di rappresentare bene nessuno dei due.
Il secondo limite è che il modello ignora completamente l’ordine delle parole nel contesto. Ricordi il meccanismo del capitolo 12: si sommano i vettori delle parole di contesto. Ma una somma è intrinsecamente commutativa, non ha memoria della posizione: “il cane morde l’uomo” e “l’uomo morde il cane” produrrebbero esattamente la stessa somma di contesto, anche se il significato è capovolto.
A questi due limiti specifici di Word2Vec se ne aggiunge poi uno più di fondo, ereditato dalle reti neurali in generale: l’opacità di cui parlavamo nel capitolo 9. Nessuno decide a priori cosa debbano significare le dimensioni dello spazio che abbiamo costruito: è tutto appreso durante l’addestramento, e il risultato non è qualcosa di immediatamente intelligibile per un essere umano.
Eppure, dentro questi limiti, lo spazio che Word2Vec costruisce nasconde una proprietà sorprendente: si può fare aritmetica sui vettori delle parole, e il risultato ha ancora un senso compiuto. L’esempio più celebre: prendi il vettore di “re”, sottrai il vettore di “uomo”, aggiungi il vettore di “donna”. Il punto a cui arrivi nello spazio denso è vicinissimo al vettore di “regina”.
Non è un caso isolato. Lo stesso schema si ritrova per moltissime altre coppie di concetti: relazioni geografiche, tempi verbali, comparativi e superlativi. È come se certe direzioni dentro lo spazio avessero acquisito da sole un significato preciso — una direzione che rappresenta, in un certo senso, il concetto di “genere”, un’altra il concetto di “regalità” — senza che nessuno lo avesse stabilito esplicitamente. È un effetto emergente della geometria che l’addestramento ha trovato, guardando soltanto i contesti.
Ma quella stessa geometria che cattura relazioni così eleganti ha un rovescio della medaglia. Se le direzioni dentro lo spazio codificano concetti reali, finiscono per assorbire anche i bias presenti nei testi su cui il modello è stato allenato. Un caso ormai classico, documentato da Bolukbasi e colleghi nel 2016 e poi da Caliskan, Bryson e Narayanan su Science nel 2017: nello spazio, il vettore di “dottore” risulta più vicino al vettore di “uomo” che al vettore di “donna” — la distanza tra dottore e uomo è minore della distanza tra dottore e donna.
Il modello non ha inventato questo bias dal nulla: lo ha semplicemente imparato, con estrema fedeltà, dal modo in cui quelle parole comparivano insieme nei testi di addestramento. Ed è una scoperta che ha avuto una ricaduta curiosa: gli embedding sono usciti dai confini dell’intelligenza artificiale e sono diventati essi stessi uno strumento di ricerca per i linguisti, che li usano proprio per misurare quantitativamente i bias presenti in una lingua o in un corpus di testi, sfruttando esattamente queste distanze geometriche.
Resta però il problema pratico, ed è un problema che va ben oltre l’accademia: se questi embedding finiscono dentro un sistema che, ad esempio, seleziona candidati per un lavoro, quel bias geometrico rischia di tradursi in una discriminazione concreta.
Nonostante tutto questo, gli embedding restano alla base di ogni large language model moderno. Ma un LLM non riusa i vettori di Word2Vec: a sopravvivere è l’idea, non quei numeri. Ogni modello impara la propria tabella di embedding da zero, insieme a tutto il resto della rete, e non la impara su parole intere ma su pezzi di parola — ed è proprio il tema del capitolo 15. Quella tabella vive poi dentro architetture ben più complesse, capaci di superare anche l’ordine delle parole e l’ambiguità dei significati multipli. L’architettura diventata dominante in questo ambito è quella del Transformer, che vedremo nella Serie 4.