Nel capitolo 3 abbiamo detto che allenare un modello significa trovare i pesi che rendono la loss la più piccola possibile, e che la discesa del gradiente scende lungo la superficie di loss fino a un minimo. Ma abbiamo lasciato in sospeso una domanda: in che direzione conviene fare il passo? Rispondere a questa domanda è tutto ciò che fa la backpropagation.
Dove sta il minimo. Partiamo da come si troverebbe un minimo a scuola. Data una funzione, il suo punto di minimo si trova dove la derivata prima si azzera: nel punto più basso la curva è momentaneamente piatta, la pendenza è zero. Per la nostra loss il principio è identico, con una complicazione: la loss non dipende da una sola variabile ma da tutti i pesi del modello. Al posto di una singola derivata abbiamo allora una derivata parziale della loss rispetto a ciascun peso — quanto la loss cambierebbe muovendo quel peso e tenendo fermi tutti gli altri. Il vettore che raccoglie tutte queste derivate parziali si chiama gradiente.
Il gradiente non è solo un elenco di numeri: ha un significato geometrico preciso. In ogni punto della superficie di loss esso punta nella direzione di massima pendenza in salita — la direzione lungo cui la loss cresce più rapidamente. E qui si chiude il cerchio con il capitolo 3: se il gradiente indica dove si sale più ripidi, per scendere basta andare nella direzione opposta. È esattamente ciò che fa la discesa del gradiente. Il minimo, dal canto suo, sta dove il gradiente si annulla: dove non c’è più nessuna direzione in cui scendere.
Perché non si risolve, si scende. Verrebbe voglia di fare come a scuola: imporre gradiente uguale a zero e risolvere il sistema. Su un modello reale è impossibile. Un sistema del genere avrebbe milioni — oggi miliardi — di equazioni, una per peso, quasi tutte non lineari e intrecciate fra loro: non esiste formula chiusa che lo risolva. Ecco perché si rinuncia a risolvere e si ripiega sullo scendere: la discesa del gradiente non trova il minimo in un colpo solo, ci arriva a piccoli passi. Ma per fare ogni passo serve comunque il gradiente in quel punto — cioè la derivata della loss rispetto a ogni singolo peso. Come si calcolano, in modo efficiente, milioni di derivate? È qui che entra la backpropagation.
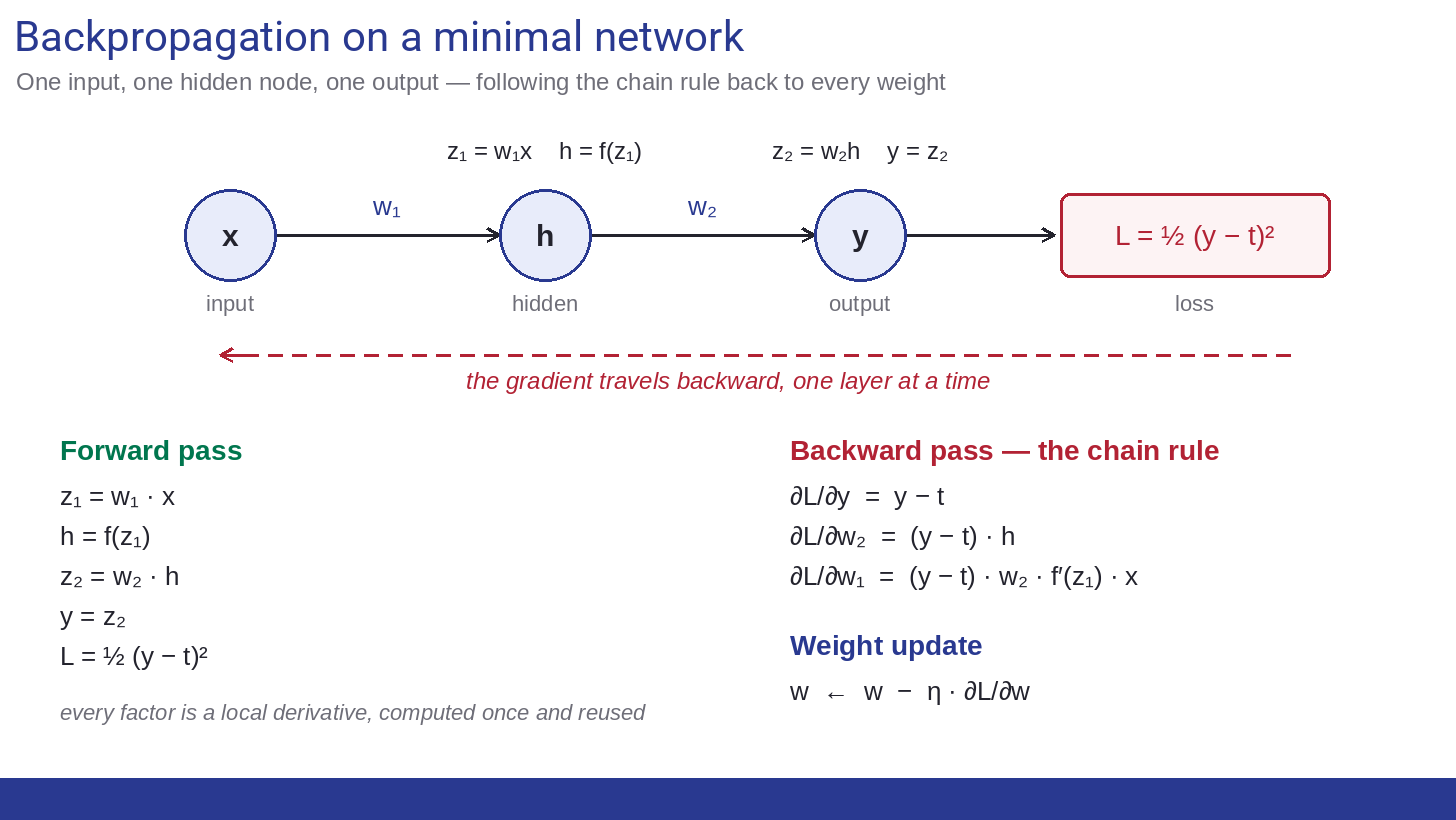
La regola della catena. Guardiamo la rete minima del diagramma: l’input x entra nel nodo nascosto attraverso il peso w₁, ne esce trasformato in h, attraversa il peso w₂ fino all’uscita y, e da y si calcola la loss L. La loss non dipende da w₁ direttamente: dipende da y, che dipende da h, che dipende da w₁. È una catena di dipendenze.
E per le catene esiste una regola precisa, la regola della catena (chain rule): la derivata di una funzione composta è il prodotto delle derivate dei singoli anelli. La derivata della loss rispetto a w₁ si spezza così nel prodotto di fattori locali — ∂L/∂y · ∂y/∂h · ∂h/∂w₁ — ciascuno semplice da calcolare da solo.
I conti, per esteso. Con la loss L = ½ (y − t)², il primo fattore è il più semplice di tutti: ∂L/∂y = y − t, l’errore grezzo, la distanza fra ciò che la rete ha predetto e ciò che avrebbe dovuto predire. Da lì si risale:
- ∂L/∂w₂ = (y − t) · h — l’errore moltiplicato per il valore che entrava in w₂;
- ∂L/∂w₁ = (y − t) · w₂ · f′(z₁) · x — lo stesso errore moltiplicato per w₂, per la derivata locale del nodo nascosto e per l’input x.
Un fattore per ogni anello della catena, esattamente come promesso. E si noti una cosa: in entrambe le formule compare (y − t), l’errore all’uscita. È il segnale che si propaga all’indietro, e ogni peso ne riceve una quota — la sua fetta di responsabilità sull’errore complessivo. Più un peso ha contribuito allo sbaglio, più grande è la sua derivata, più deciso sarà il suo aggiustamento.
Perché ogni strato può lavorare per conto proprio. Guardiamo di nuovo i fattori della catena per w₁: uno di essi — ∂L/∂y — è esattamente il fattore che serviva anche per w₂. Non è un caso. Man mano che si risale lungo la rete, ogni strato riutilizza il lavoro già fatto dallo strato più a valle: la derivata della loss rispetto all’uscita di uno strato si ottiene da quella dello strato successivo, moltiplicata per una derivata locale — che riguarda solo quello strato, di quanto la sua uscita cambia al variare del suo ingresso o del suo peso.
Ed è questo a rendere il calcolo trattabile. Nessuno strato deve rifare i conti a partire dalla loss: gli basta ricevere dallo strato a valle un unico numero — quanto la loss è sensibile alla sua uscita — e combinarlo con le proprie derivate locali, che dipendono solo da ciò che ha calcolato lui. In questo senso ogni strato lavora guardando soltanto sé stesso e il messaggio che gli arriva da valle, senza dover conoscere l’intera rete.
I due passaggi. Concretamente, l’algoritmo fa due passaggi sulla rete. Prima un passaggio in avanti — il forward pass — in cui l’input attraversa la rete fino alla loss, e lungo la strada si annotano i valori intermedi: z₁, h, z₂, y. Poi un passaggio all’indietro — il backward pass — che parte dalla loss e risale strato per strato, propagando quel numero di sensibilità e moltiplicandolo di volta in volta per le derivate locali. Ogni valore utile viene calcolato una volta sola e riutilizzato a ritroso, invece di essere ricalcolato da capo per ogni peso. È da qui che viene il nome: l’errore si propaga all’indietro attraverso la rete.
E il training set? Finora abbiamo ragionato su un singolo esempio — un x, una t — ma la loss vera, come nel capitolo 3, è la somma degli errori su tutti gli esempi del training set. Il passaggio è semplice: il gradiente della loss totale è la somma dei gradienti calcolati su ciascun esempio. Si fa quindi un forward e un backward pass per ogni esempio, si sommano i contributi, e solo a quel punto si aggiornano i pesi. Un passo così — che guarda l’intero training set prima di muoversi — si chiama batch.
C’è però un problema pratico: se il training set ha milioni di esempi, aspettare di averli visti tutti per fare un solo passo è lentissimo. Nella pratica si sceglie una via di mezzo: si divide il training set in piccoli gruppi, i mini-batch — poche decine o centinaia di esempi — si calcola il gradiente su un mini-batch e si fa subito un passo. Poi il mini-batch successivo, e così via. Ogni passo usa una stima soltanto approssimata del gradiente vero, ma se ne fanno moltissimi di più: un compromesso che converge molto più in fretta. È la cosiddetta discesa del gradiente stocastica, ed è così che vengono allenate quasi tutte le reti reali.
L’aggiornamento. A questo punto abbiamo tutto. Per ogni peso: w ← w − η · ∂L/∂w. Quel η — il learning rate — è la lunghezza del passo: piccolo e la discesa è lenta ma stabile, grande e si rischia di scavalcare il minimo. Un forward pass, un backward pass, un aggiustamento di tutti i pesi: ripetuto milioni di volte, è tutto l’allenamento di una rete neurale.
Ed è anche la radice della sua opacità. La backpropagation trova pesi che funzionano, ma non ci dice cosa ciascuno significhi. Alla fine restano miliardi di numeri, sintonizzati alla perfezione, che nessuno ha scritto e nessuno sa davvero leggere — ed è proprio da qui che parte il prossimo capitolo.