Nel capitolo 6 avevamo detto che, combinando abbastanza neuroni, si può rappresentare qualunque relazione fra input e output — e avevamo aggiunto che era un risultato matematico preciso, ma con un’avvertenza importante, rimandata a più tardi. È il momento di saldare quel debito.
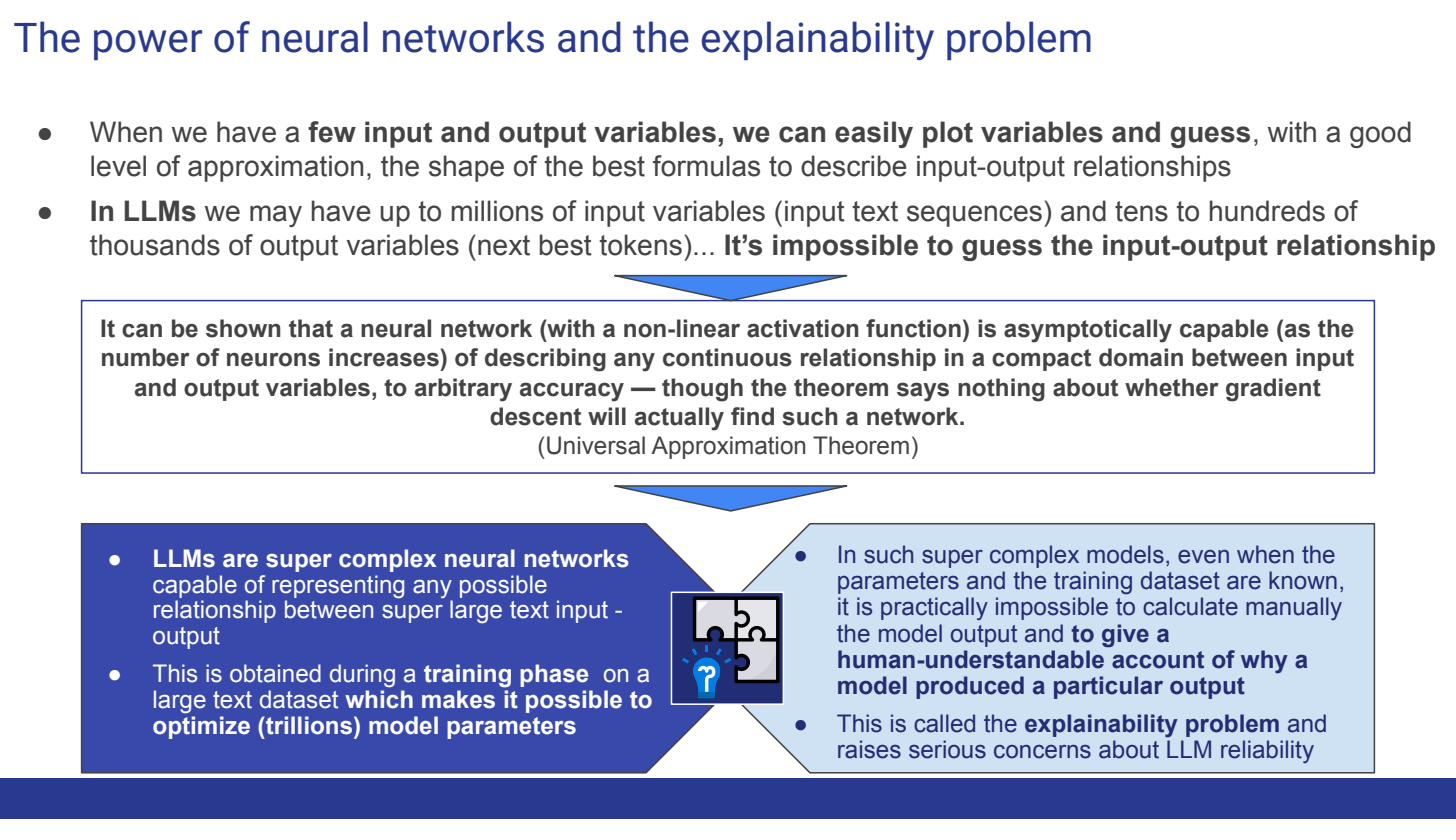
Il teorema, e ciò che non dice. Il risultato si chiama teorema di approssimazione universale: una rete con almeno uno strato nascosto, di dimensione sufficiente e con attivazione non lineare, può approssimare qualunque funzione continua su un dominio compatto con la precisione che si desidera. Detto così sembra una promessa illimitata, ed è qui che serve l’avvertenza: il teorema garantisce che quella rete esiste. Non dice come trovarla, né quanto debba essere grande, né se la discesa del gradiente sarà mai capace di arrivarci in un tempo ragionevole. È un’esistenza teorica, non una ricetta pratica.
Ed è una distinzione che vale la pena tenere presente ogni volta che si sente dire che una rete neurale “può fare qualsiasi cosa”. Può, in principio. Il fatto che in pratica ci arrivi davvero non lo garantisce nessun teorema: lo garantiscono soltanto i dati, l’architettura e l’ottimizzazione — cioè tutto il lavoro dei capitoli precedenti.
L’altra faccia: l’opacità. Il capitolo 8 si chiudeva osservando che la backpropagation trova pesi che funzionano, ma non ci dice cosa ciascuno significhi. Ora si può dire perché. Ogni peso è un numero che ha senso solo in relazione a milioni di altri; non esiste alcun dizionario che traduca un peso in un concetto umano; e il risultato è che nemmeno chi costruisce il modello sa spiegare perché, dato un certo input, sia uscita una certa risposta.
Questa mancanza di trasparenza non è un fastidio teorico: è un problema di affidabilità concreto. Se non sappiamo perché un modello risponde in un certo modo, è difficile fidarsi ciecamente delle sue risposte in contesti delicati — ed è esattamente il tipo di contesto in cui questi modelli vengono oggi messi al lavoro. È da questa preoccupazione che nasce un intero filone di ricerca dedicato a capire cosa succede dentro la rete: la mechanistic interpretability.
Schemi di attivazione e feature. Per vedere come funziona serve prima rendere preciso un concetto. Prendiamo un singolo strato della rete, con un certo numero di neuroni. Dato un input, si può osservare quali di quei neuroni restituiscono un valore sensibilmente diverso da zero: quei neuroni sono, per così dire, accesi, e l’insieme di tutti quelli accesi per un dato input è il suo schema di attivazione — un punto preciso in uno spazio con tante dimensioni quanti sono i neuroni di quello strato. Le dimensioni, si noti, sono i neuroni: non c’è nulla di più esotico.
E la combinazione di neuroni che si accendono insieme per codificare un concetto è ciò che in interpretability si chiama una caratteristica, o feature. Una feature non vive dentro un singolo neurone: è una direzione dentro lo spazio delle attivazioni.
La sovrapposizione. Prendiamo il concetto di “ponte Golden Gate”. Ci si aspetterebbe che, a forza di leggere testi su quel ponte, la rete gli dedichi un neurone tutto suo. Non è così: quello stesso neurone si attiva anche per concetti che con il ponte non hanno nulla a che fare. La ragione è semplice e strutturale — le feature dentro una rete sono molte di più dei neuroni disponibili, quindi ciascuna si accontenta di una combinazione di più neuroni invece di averne uno dedicato. Feature diverse finiscono per condividere gli stessi pochi neuroni, sovrapponendosi: è il fenomeno noto come sovrapposizione (superposition).
Per farsene un’immagine, si immagini uno strato con soli tre neuroni: uno spazio minuscolo, appena tre dimensioni. Dentro uno spazio così piccolo devono convivere centinaia di concetti diversi. Non c’è posto per tenerli distanti, quindi le loro direzioni finiscono ammassate, quasi incollate l’una all’altra: si cambia di poco la combinazione di quei tre numeri e si scivola da un concetto all’altro. È uno spazio denso, affollato, e per un umano difficile da leggere.
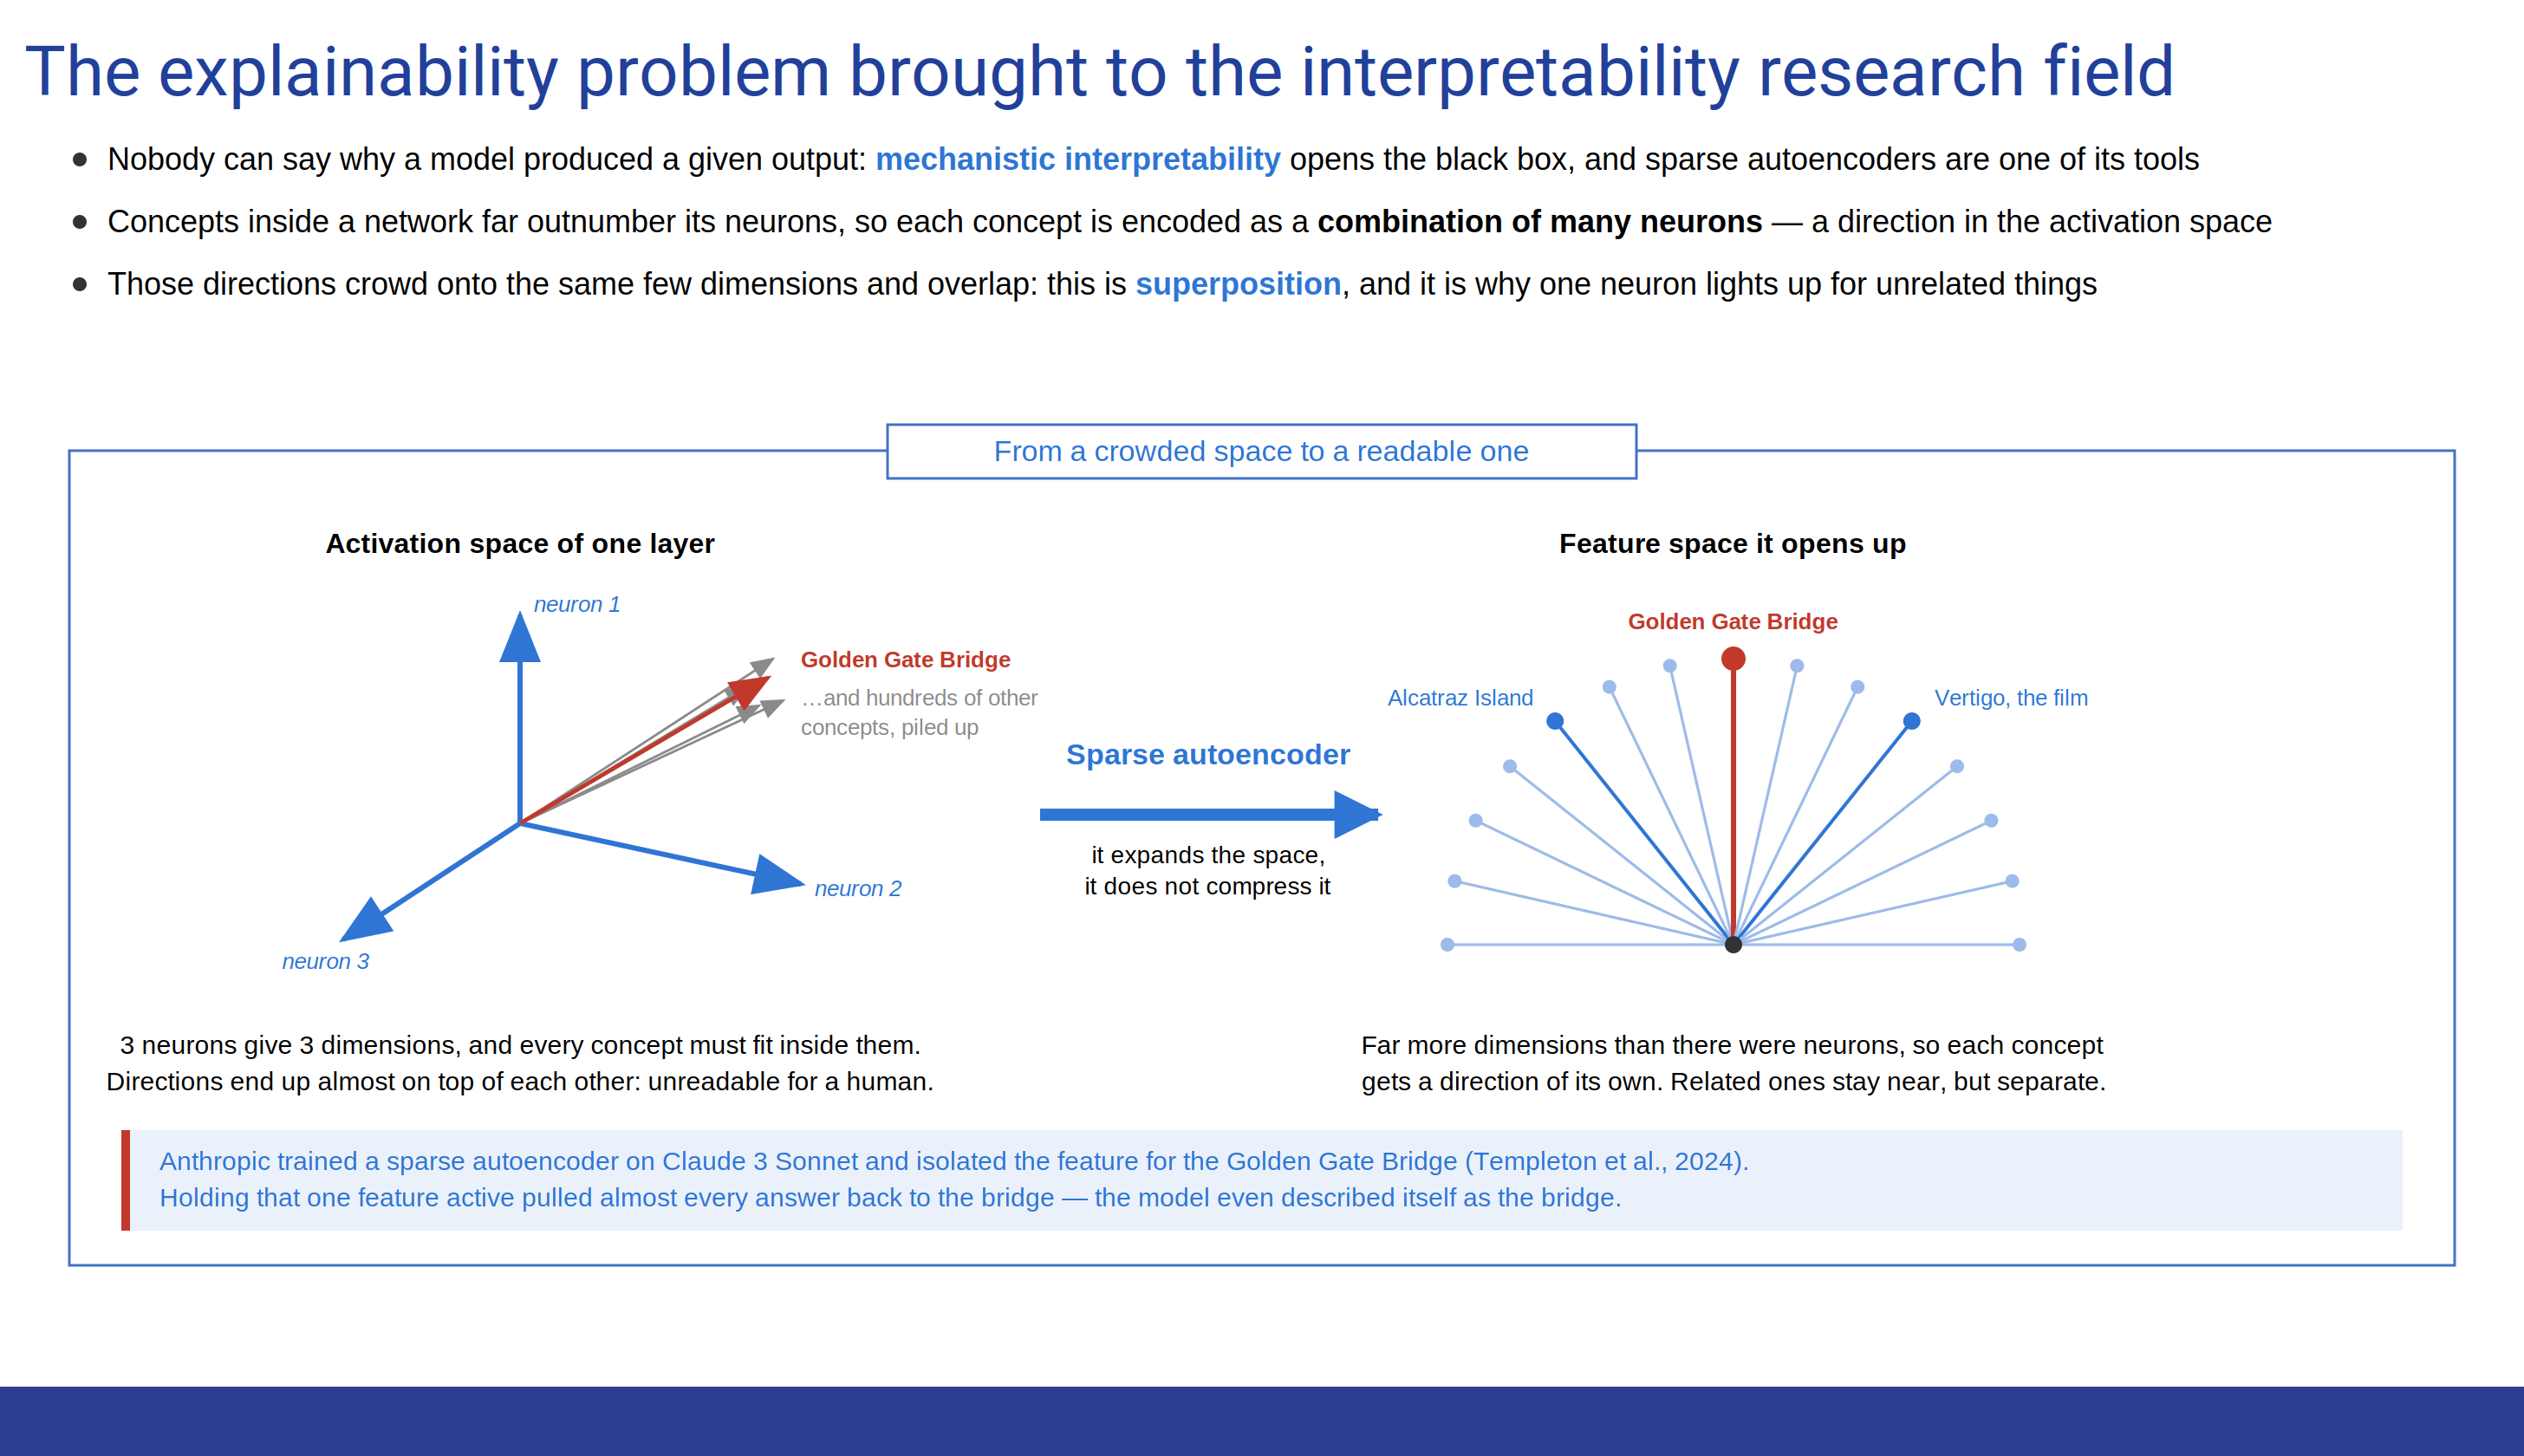
Gli autoencoder sparsi. Nascono per districare questa matassa. Un autoencoder tradizionale comprime un input ricco in poche dimensioni essenziali e poi cerca di ricostruirlo. Un autoencoder sparso fa l’opposto: prende quelle poche dimensioni sovraffollate e le riespande in uno spazio molto più ampio, dove ogni feature può ottenere una direzione più propria, più distante dalle altre. Lo spazio diventa meno denso, più diradato, e in quel diradamento ogni direzione diventa più facilmente interpretabile.
Non automaticamente leggibile, però: capire che cosa rappresenti davvero una certa direzione richiede ancora un lavoro paziente, che consiste nell’esaminare quali input la fanno accendere. È esattamente il lavoro che i ricercatori di Anthropic hanno fatto su Claude 3 Sonnet, quando sono riusciti a individuare la direzione legata al ponte Golden Gate. Forzando quella singola feature a restare attiva — una tecnica chiamata steering — hanno fatto sì che il modello riportasse quasi ogni risposta al ponte, arrivando a descrivere sé stesso come il ponte. Attorno a quella feature hanno trovato anche quelle vicine: Alcatraz, Ghirardelli Square, il film di Hitchcock Vertigo.
Un dato dà la misura di quanto la sovrapposizione sia la norma e non l’eccezione: per l’82% delle feature estratte, non esiste alcun neurone fortemente correlato con esse. Le feature stanno nelle combinazioni, non nei singoli nodi.
Sul tema degli spazi densi e sparsi torneremo nei prossimi capitoli, parlando di embedding — dove però sparso avrà un’accezione diversa, quasi opposta a questa: là indicherà una rappresentazione ad altissima dimensione e priva di significato, da comprimere in uno spazio denso per guadagnarlo. Vale la pena tenere separate le due accezioni.
I circuiti. Il passo successivo, verso cui la ricerca si sta muovendo ora, è quello dei circuiti. Se gli autoencoder sparsi dicono quali feature esistono dentro la rete, i circuiti provano a ricostruire la sequenza con cui quelle feature si accendono una dopo l’altra, strato dopo strato, fino all’output finale — un po’ come ricostruire lo schema elettrico dietro a un singolo ragionamento del modello.
Le reti neurali restano opache. Ma è un’opacità su cui, oggi, si sta facendo moltissima strada. E prima di proseguire verso il linguaggio, resta una domanda di inventario: la rete fully connected di cui abbiamo parlato finora è solo una delle forme possibili. Quali sono le altre, e a cosa servono? È il tema del prossimo capitolo.