Il capitolo 10 si chiudeva su un vincolo scomodo: una rete neurale, qualunque sia la sua topologia, parla solo il linguaggio dei numeri. Se vogliamo che un modello legga una frase, quella frase deve prima diventare numeri. Assegnare un numero a una parola, di per sé, è un compito banale: basta un elenco — ne useremo uno tra un attimo, proprio per vederne il limite. Il problema vero è un altro: vogliamo che quel numero non sia un’etichetta qualunque, ma porti con sé il significato della parola.
Ma cosa vuol dire, esattamente, che un numero porta con sé un significato? Qui conviene fare un passo indietro e chiedersi cosa sia il significato stesso. Se cerchiamo di definire una parola, quasi sempre lo facciamo con un’altra parola, un sinonimo: il significato non è mai qualcosa di assoluto, isolato, ma un concetto relativo. Due parole si somigliano nel significato quando sono, in un certo senso, vicine. E se il significato è una relazione di vicinanza, allora possiamo tradurlo in qualcosa che sappiamo trattare matematicamente: la vicinanza geometrica. L’idea guida di tutta la rappresentazione numerica del linguaggio sarà proprio questa: costruire uno spazio in cui parole dal significato simile occupino posizioni vicine.
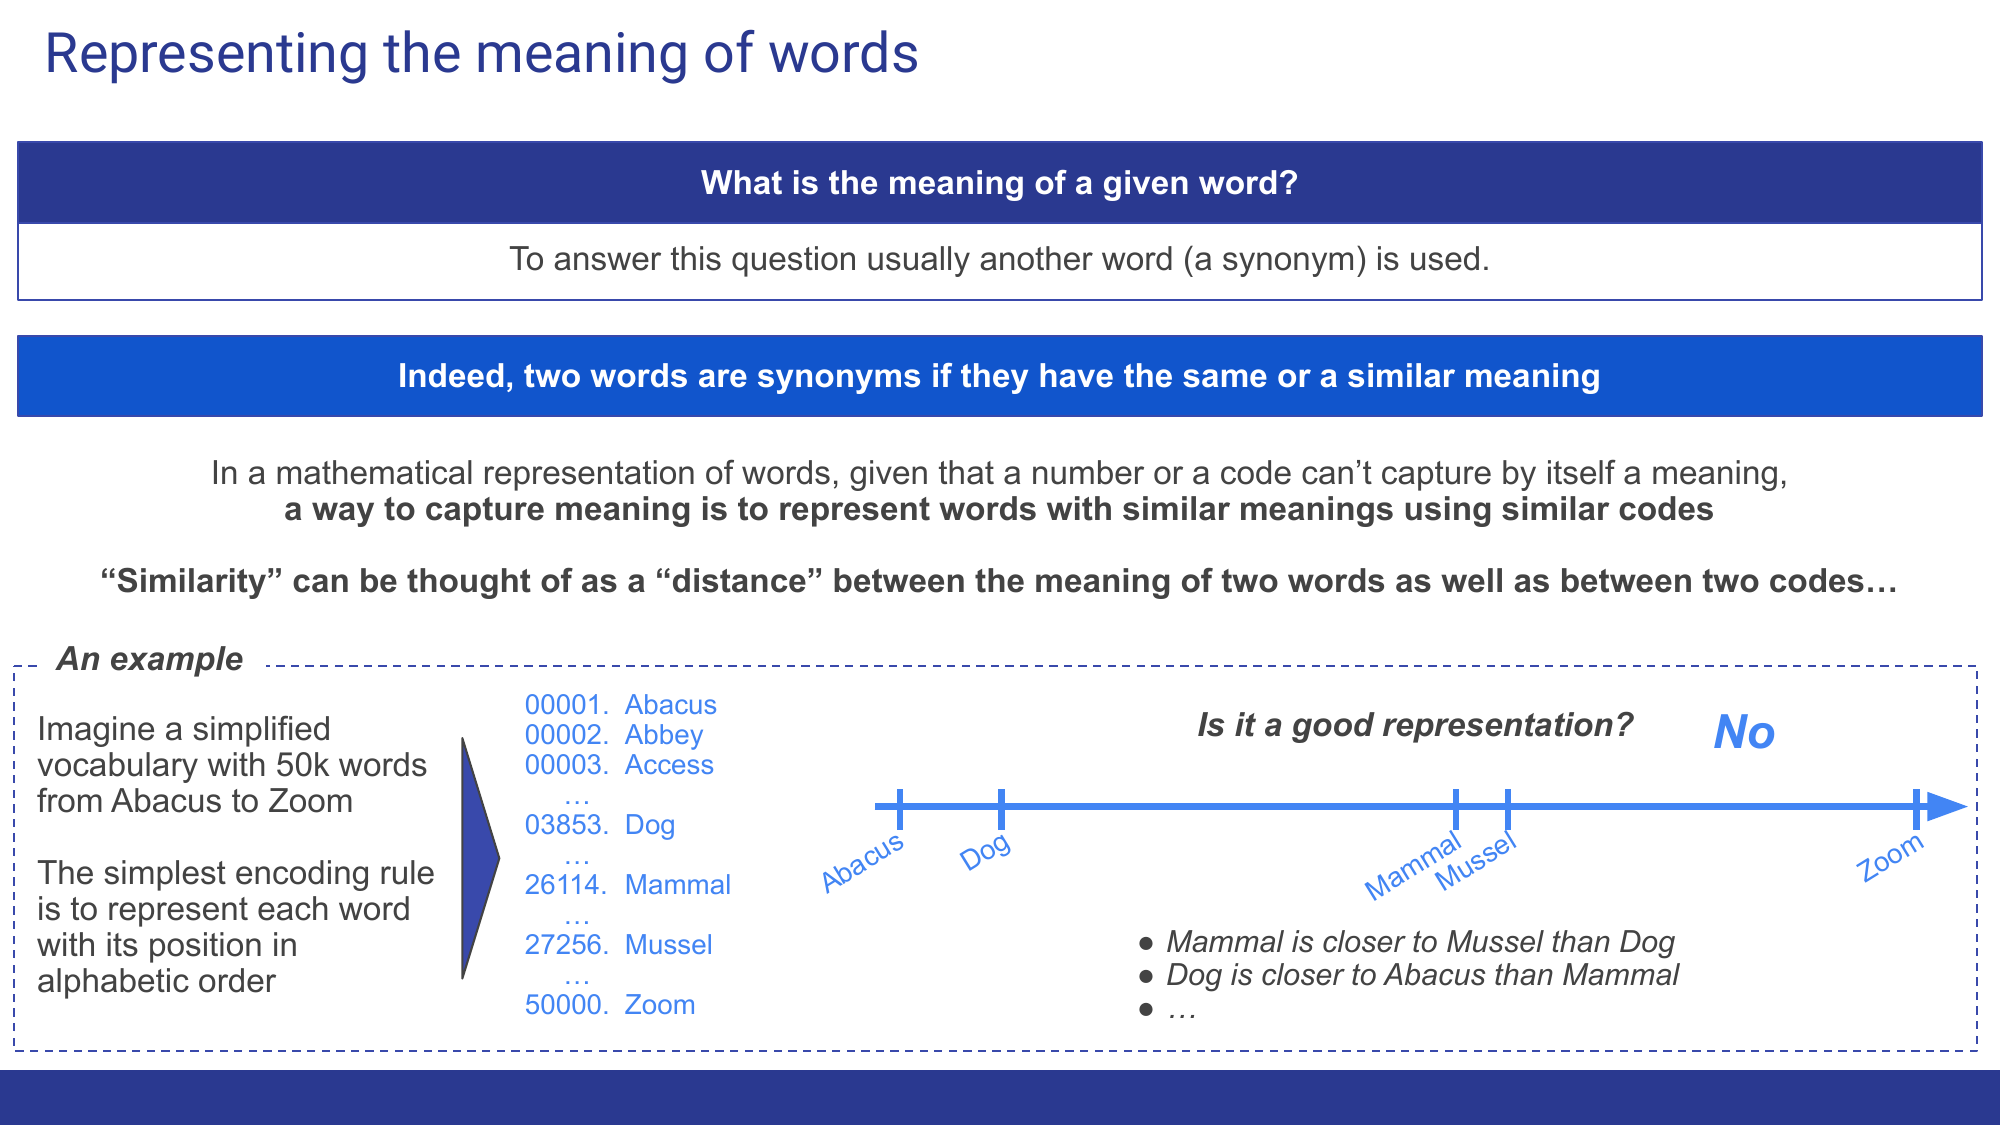
Proviamo allora la strada più ovvia. Prendiamo un vocabolario semplificato in cui la prima parola è Abacus (abaco) e l’ultima è Zoom, e assegniamo a ciascuna parola la propria posizione nell’ordine alfabetico: un numero solo, su un’unica retta. Funziona? Per niente. In questa rappresentazione Dog (cane) finisce più vicino ad Abacus che a Mammal (mammifero), e Mammal più vicino a Mussel (cozza) che a Dog. La posizione in una sequenza riflette l’ordine con cui abbiamo deciso di elencare le parole, non la vicinanza di significato tra loro.
C’è un secondo limite, ancora più profondo, che nessun riordino della lista può risolvere. Anche scegliendo il criterio più sensato possibile per allineare le parole su quell’unica retta, resterebbe impossibile rappresentare il fatto che una parola sia equidistante, per significato, da più parole diverse contemporaneamente: Dog, per esempio, dovrebbe poter essere vicino a Mammal tanto quanto a Friend (amico) e a Pet (animale domestico). Ma disposte su una retta, queste parole avranno inevitabilmente distanze reciproche che non riflettono quelle dei loro significati. Serve più spazio, letteralmente: bisogna passare da una rappresentazione lineare, su un solo asse, a una rappresentazione multidimensionale. In uno spazio con più dimensioni, ogni parola diventa un vettore, e ogni componente di quel vettore è una coordinata su uno degli assi dello spazio. La rappresentazione vettoriale più semplice di questo tipo è il one-hot encoding.
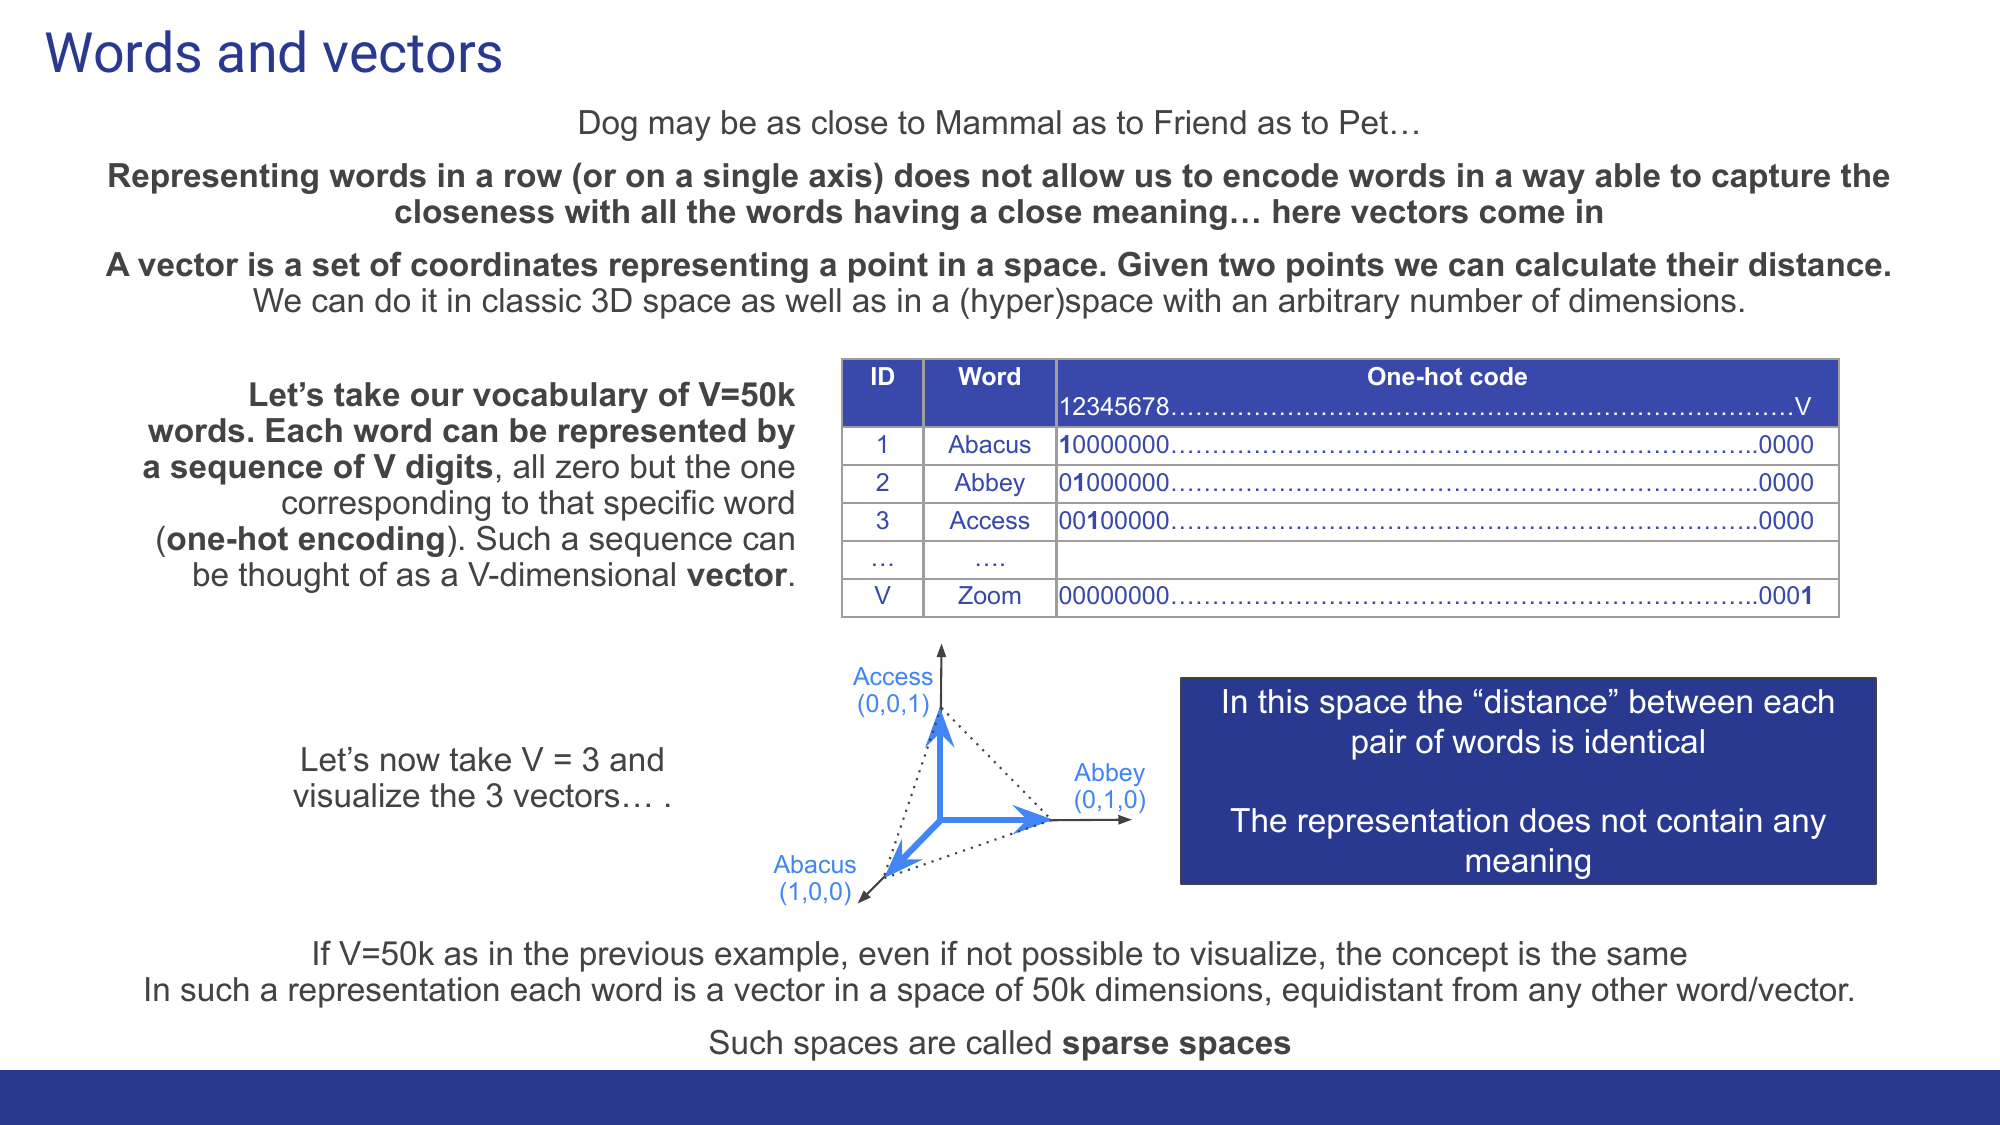
Ogni parola del vocabolario diventa un vettore lungo quanto l’intero vocabolario, fatto tutto di zeri tranne un solo uno nella posizione che la identifica. Ma lo spazio che ne risulta è sparso, perché tutte le componenti di ogni vettore, tranne una, sono zero. Questa rappresentazione codifica ogni parola in uno spazio con tante dimensioni quante sono le parole del vocabolario, dove ogni parola giace su una dimensione diversa, ortogonale a tutte le altre: due parole non hanno mai il proprio uno nella stessa posizione, e il risultato è che ogni parola finisce alla stessa identica distanza da ogni altra, che si tratti di un sinonimo stretto o di un termine senza alcuna parentela di significato.
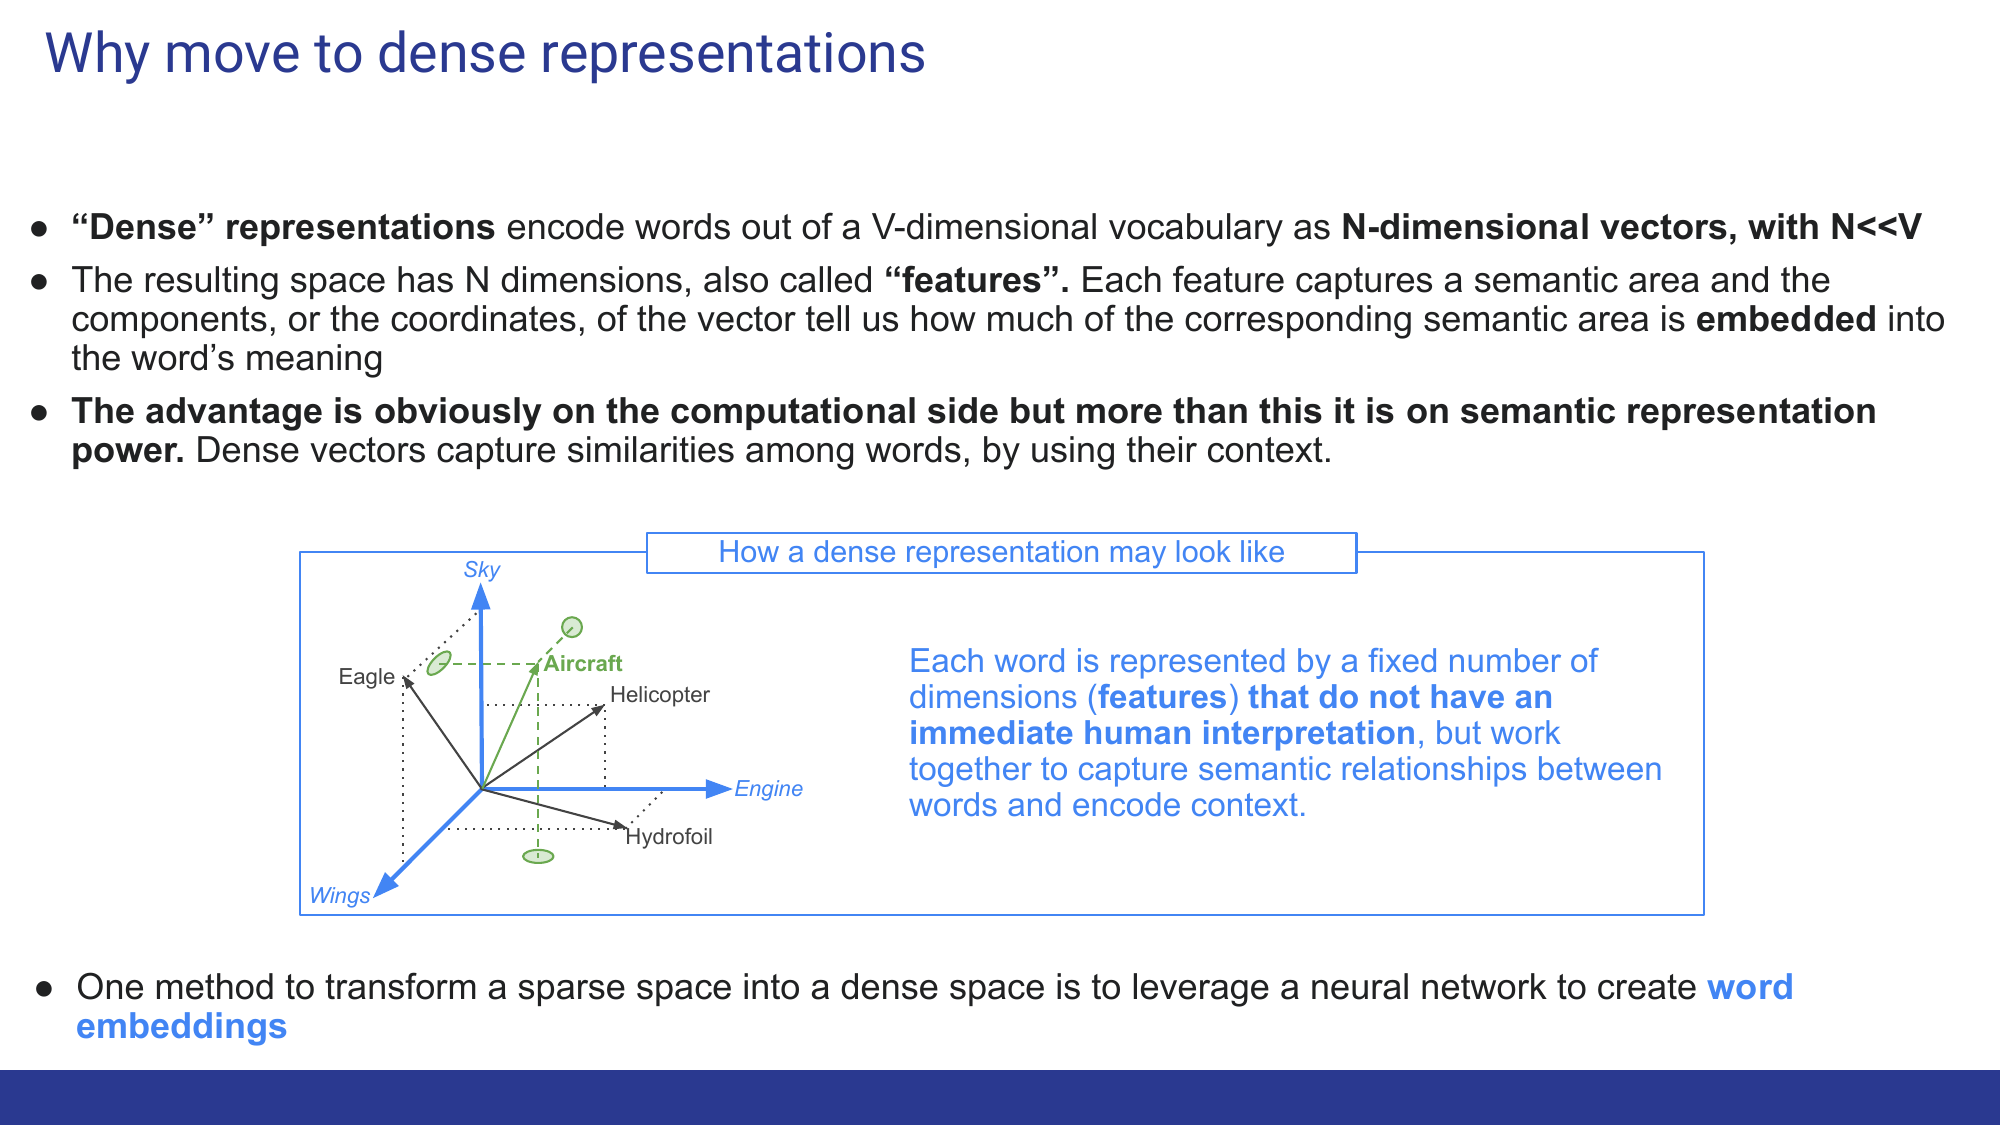
La soluzione è passare da uno spazio sparso a uno spazio denso: invece di un vettore lungo quanto l’intero vocabolario, ogni parola viene rappresentata con un numero molto più piccolo di dimensioni, ciascuna delle quali cattura una sfumatura di significato invece di limitarsi a identificare la parola. Immaginiamo, per farci un’idea, uno spazio di sole tre dimensioni, che chiamiamo Wings (ali), Engine (motore) e Sky (cielo). Helicopter (elicottero) avrebbe una componente su Sky e una su Engine, perché vola, ma grazie a un motore, non alle ali. Eagle (aquila) avrebbe una componente su Sky e una su Wings, perché vola grazie alle ali, senza motore. Hydrofoil (aliscafo) avrebbe una componente su Wings e una su Engine, perché ha entrambi ma resta sull’acqua, senza mai toccare il cielo. Aircraft (aeroplano), che possiede tutte e tre le caratteristiche insieme, avrebbe invece una componente su ciascuno dei tre assi. In questo esempio abbiamo scelto noi il significato delle tre dimensioni per rendere evidente il meccanismo, ma nella realtà nessuno lo decide a priori: è qualcosa che il modello apprende da solo durante l’addestramento, osservando in quali contesti ogni parola compare: parole che ricorrono in contesti simili finiscono in posizioni vicine. E le dimensioni che ne escono, di norma, non portano un’etichetta leggibile come Wings o Sky: funzionano, ma prese una per una non corrispondono a un concetto che sapremmo nominare. Una rappresentazione densa di questo tipo, appresa da una rete neurale, si chiama word embedding, ed è esattamente il tema del prossimo capitolo, dedicato a Word2Vec.