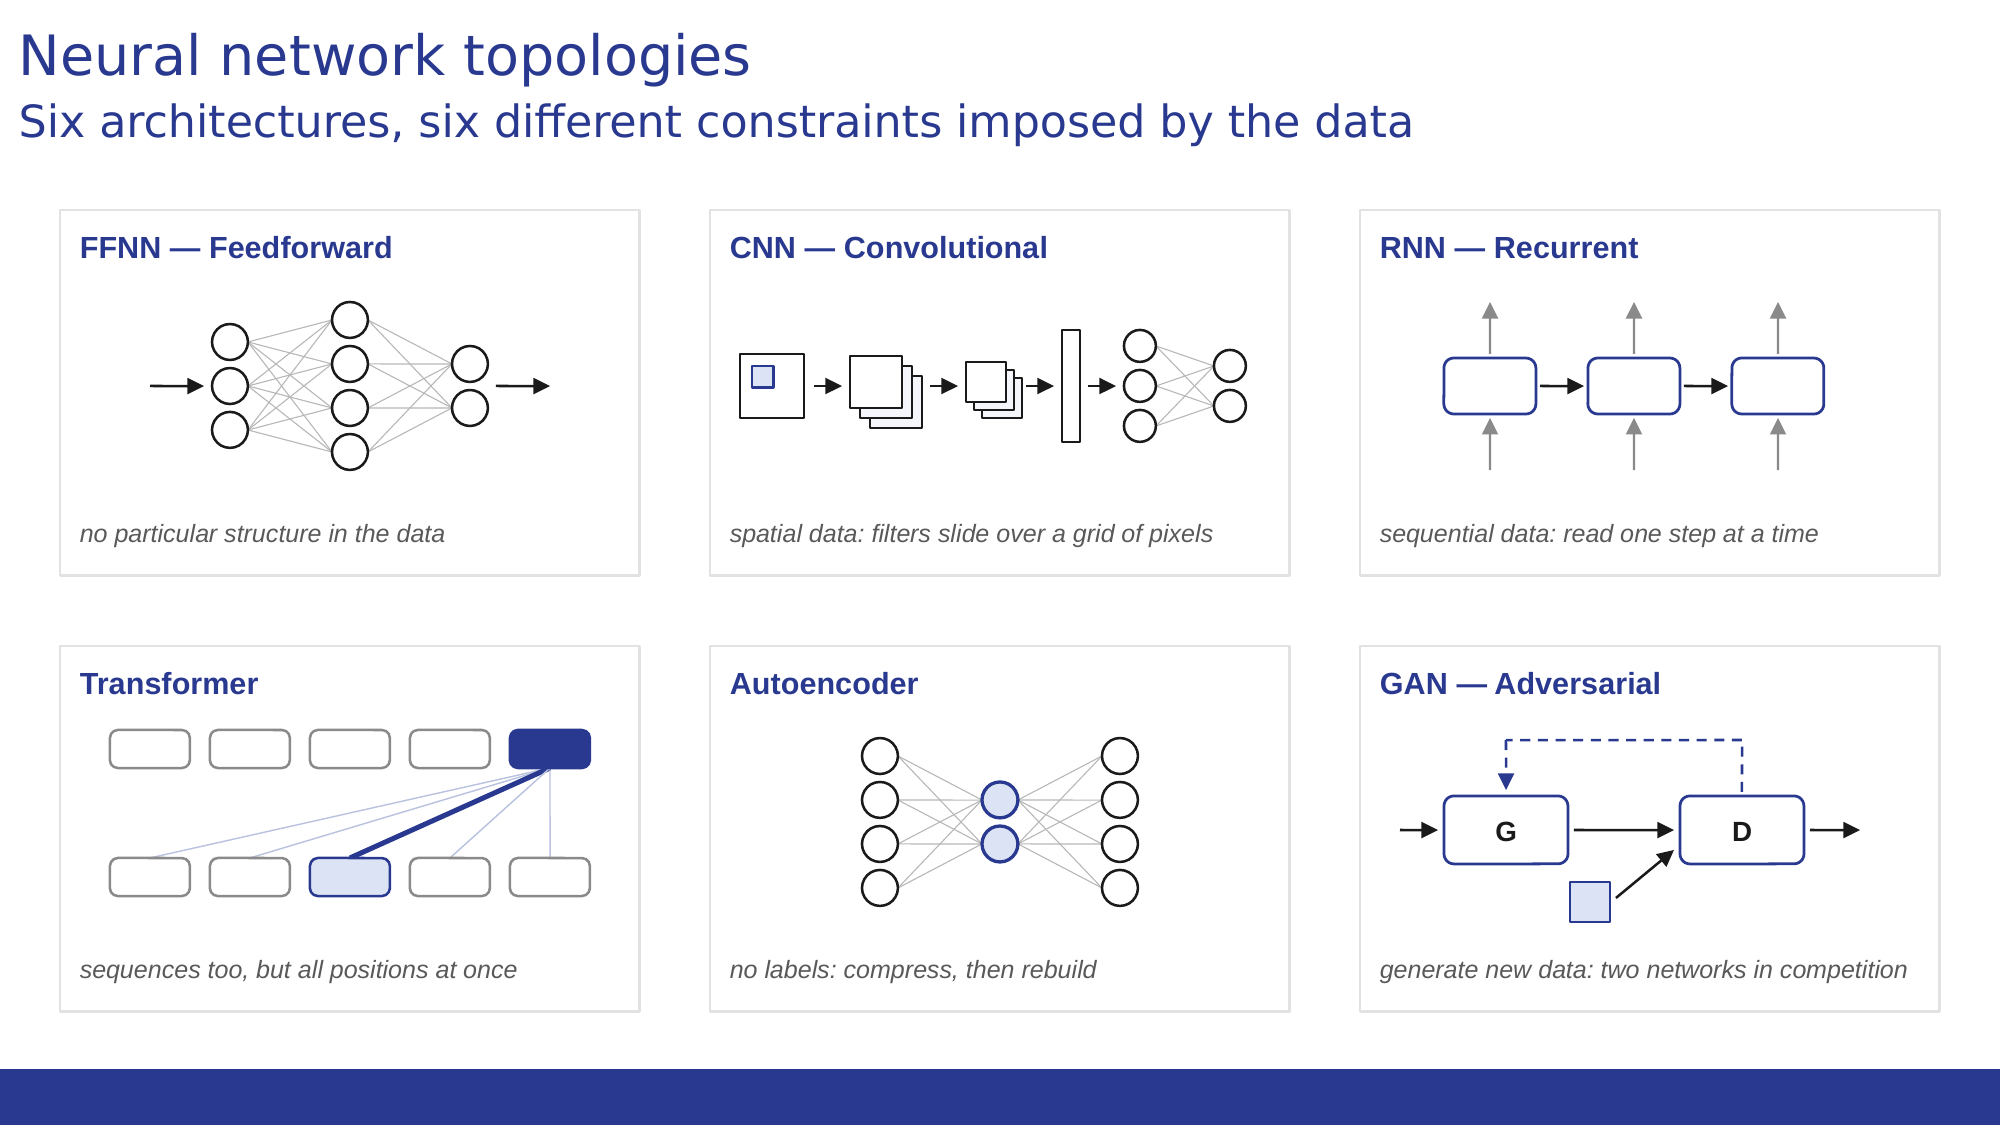
Nel capitolo 6 avevamo detto che la rete lì descritta, dove l’informazione scorre solo in avanti e ogni nodo di uno strato è collegato a tutti i nodi dello strato successivo, ovvero una rete feedforward e fully connected, è solo una delle topologie possibili, e avevamo rimandato le altre a questo capitolo. Nel capitolo 9 abbiamo richiuso il cerchio ribadendo lo stesso concetto. È il momento di mantenere quella promessa.
Ogni architettura che vedremo nasce per rispondere a un vincolo diverso imposto dai dati: un’immagine ha una struttura spaziale, una frase ha un ordine che conta, e a volte non si vuole nemmeno predire un’etichetta ma generare qualcosa di nuovo che prima non esisteva. Vedremo cinque famiglie, ciascuna costruita attorno a un’idea semplice per rispondere a uno di questi vincoli.
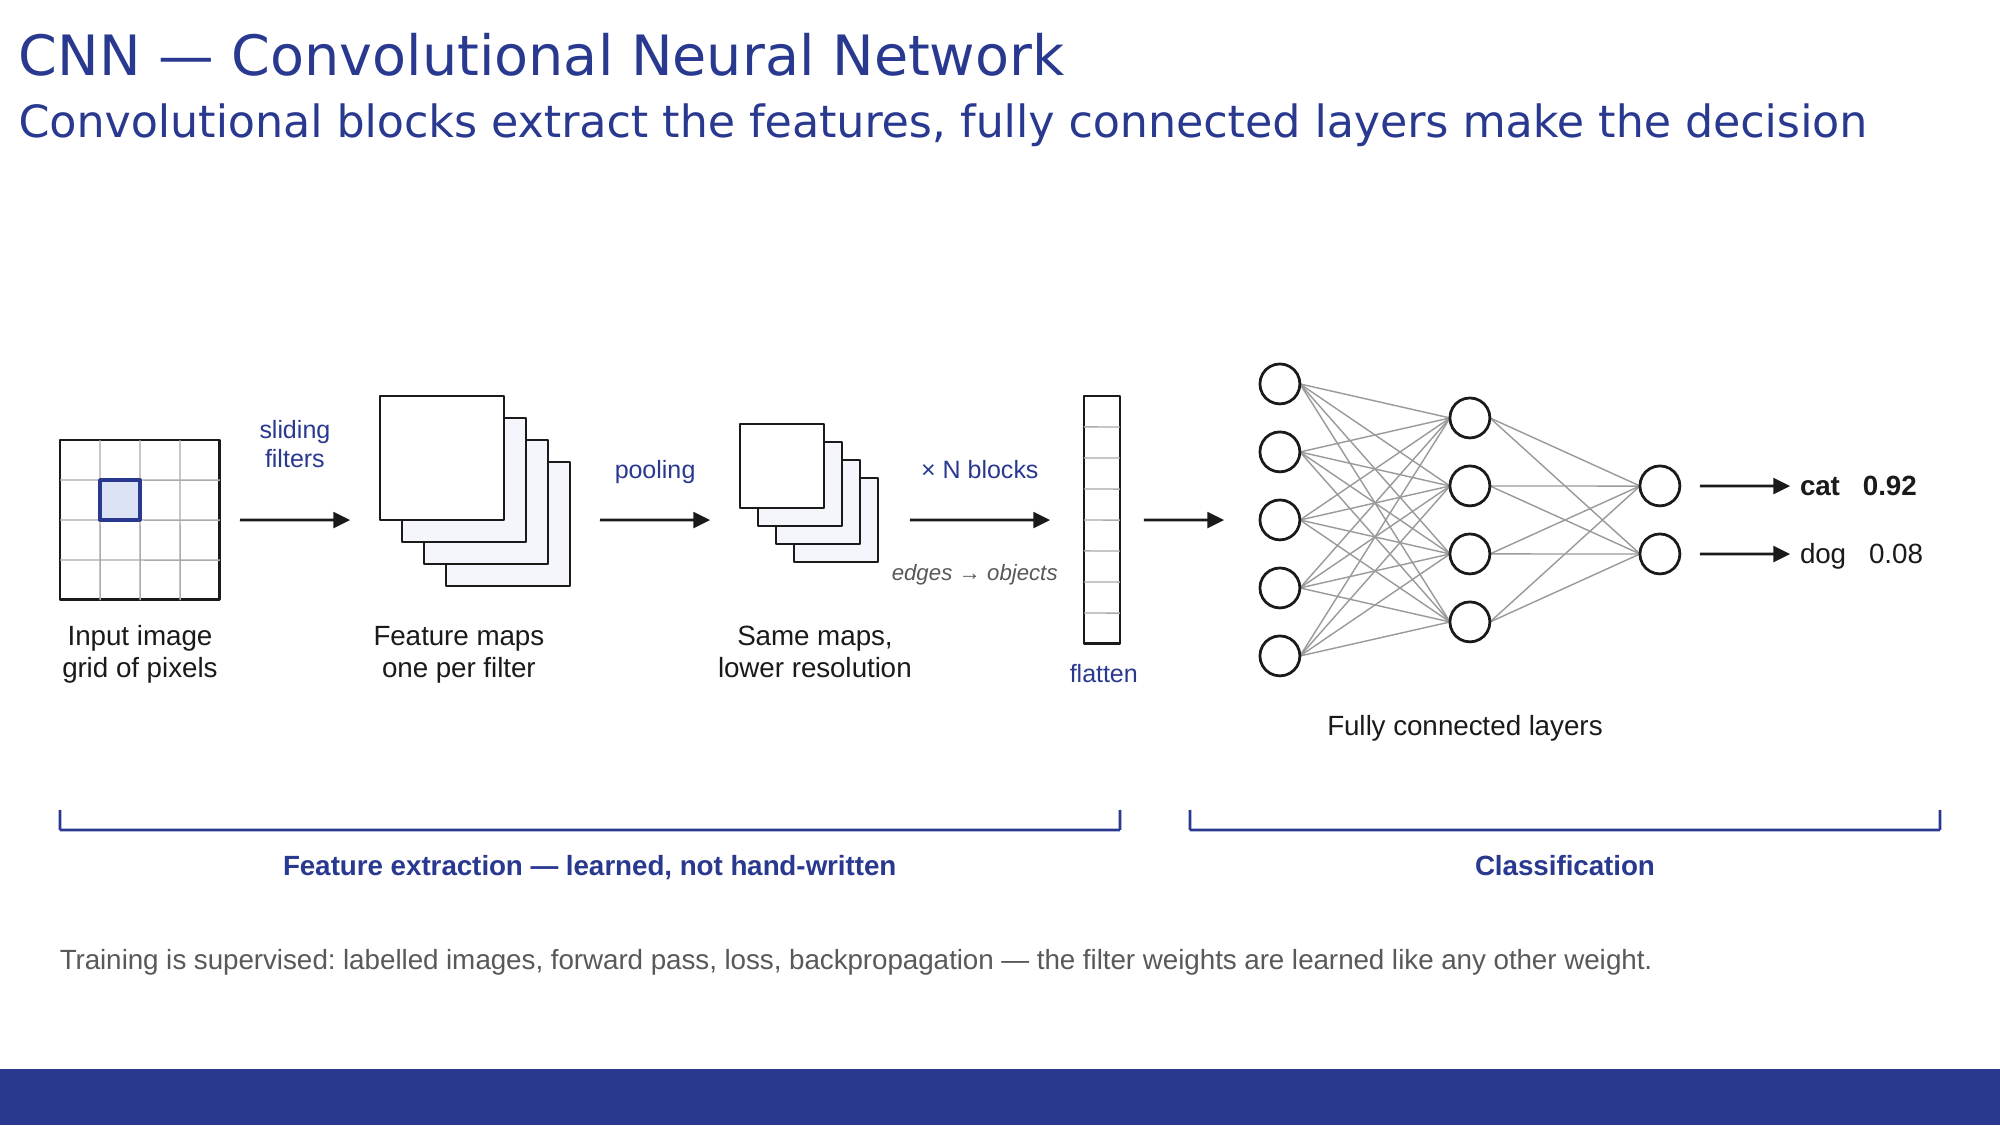
CNN, Convolutional Neural Network. Nasce per lavorare su immagini, quindi su dati organizzati in una griglia spaziale di pixel. Il nome viene proprio dall’operazione centrale: si fanno scorrere, o si convolvono, piccoli filtri sull’immagine, e ciascun filtro impara a riconoscere una caratteristica locale, un bordo, una texture, una curva, senza che nessuno gli dica a priori cosa cercare. Partendo da un’unica immagine se ne applicano tanti in parallelo, decine o centinaia, e ciascuno produce una propria mappa, così che da un’immagine si ottengono tante mappe quanti sono i filtri, una per ogni caratteristica individuata. Uno strato di pooling comprime poi la risoluzione spaziale di ciascuna mappa, tenendo per ogni zona solo il segnale più forte e scartando la posizione esatta in cui si trovava: la caratteristica resta, ma la rete diventa meno sensibile a piccoli spostamenti. Impilando più blocchi di questo tipo, gli strati successivi combinano le caratteristiche più semplici in forme via via più complesse, dai bordi agli oggetti interi.
Dopo diversi blocchi di filtraggio e pooling, le mappe di caratteristiche vengono appiattite in un unico vettore e passate a uno o più strati fully connected, esattamente come quelli visti nei capitoli precedenti, che combinano tutte le caratteristiche estratte per produrre l’output finale, per esempio la probabilità che l’immagine contenga un gatto piuttosto che un cane. In un certo senso, la parte convoluzionale fa il lavoro di trovare le caratteristiche giuste, e la parte finale fully connected fa il lavoro di decidere sulla base di quelle caratteristiche.
L’addestramento è supervisionato: si danno alla rete immagini etichettate, e forward pass, loss e backpropagation aggiustano i pesi, compresi quelli dentro ciascun filtro. Nessun umano scrive i filtri: è l’addestramento a decidere da solo, esempio dopo esempio, quali caratteristiche convenga estrarre per distinguere, per esempio, un gatto da un cane. L’ambito principale resta la visione artificiale: riconoscimento di immagini, rilevamento di oggetti, diagnostica per immagini.
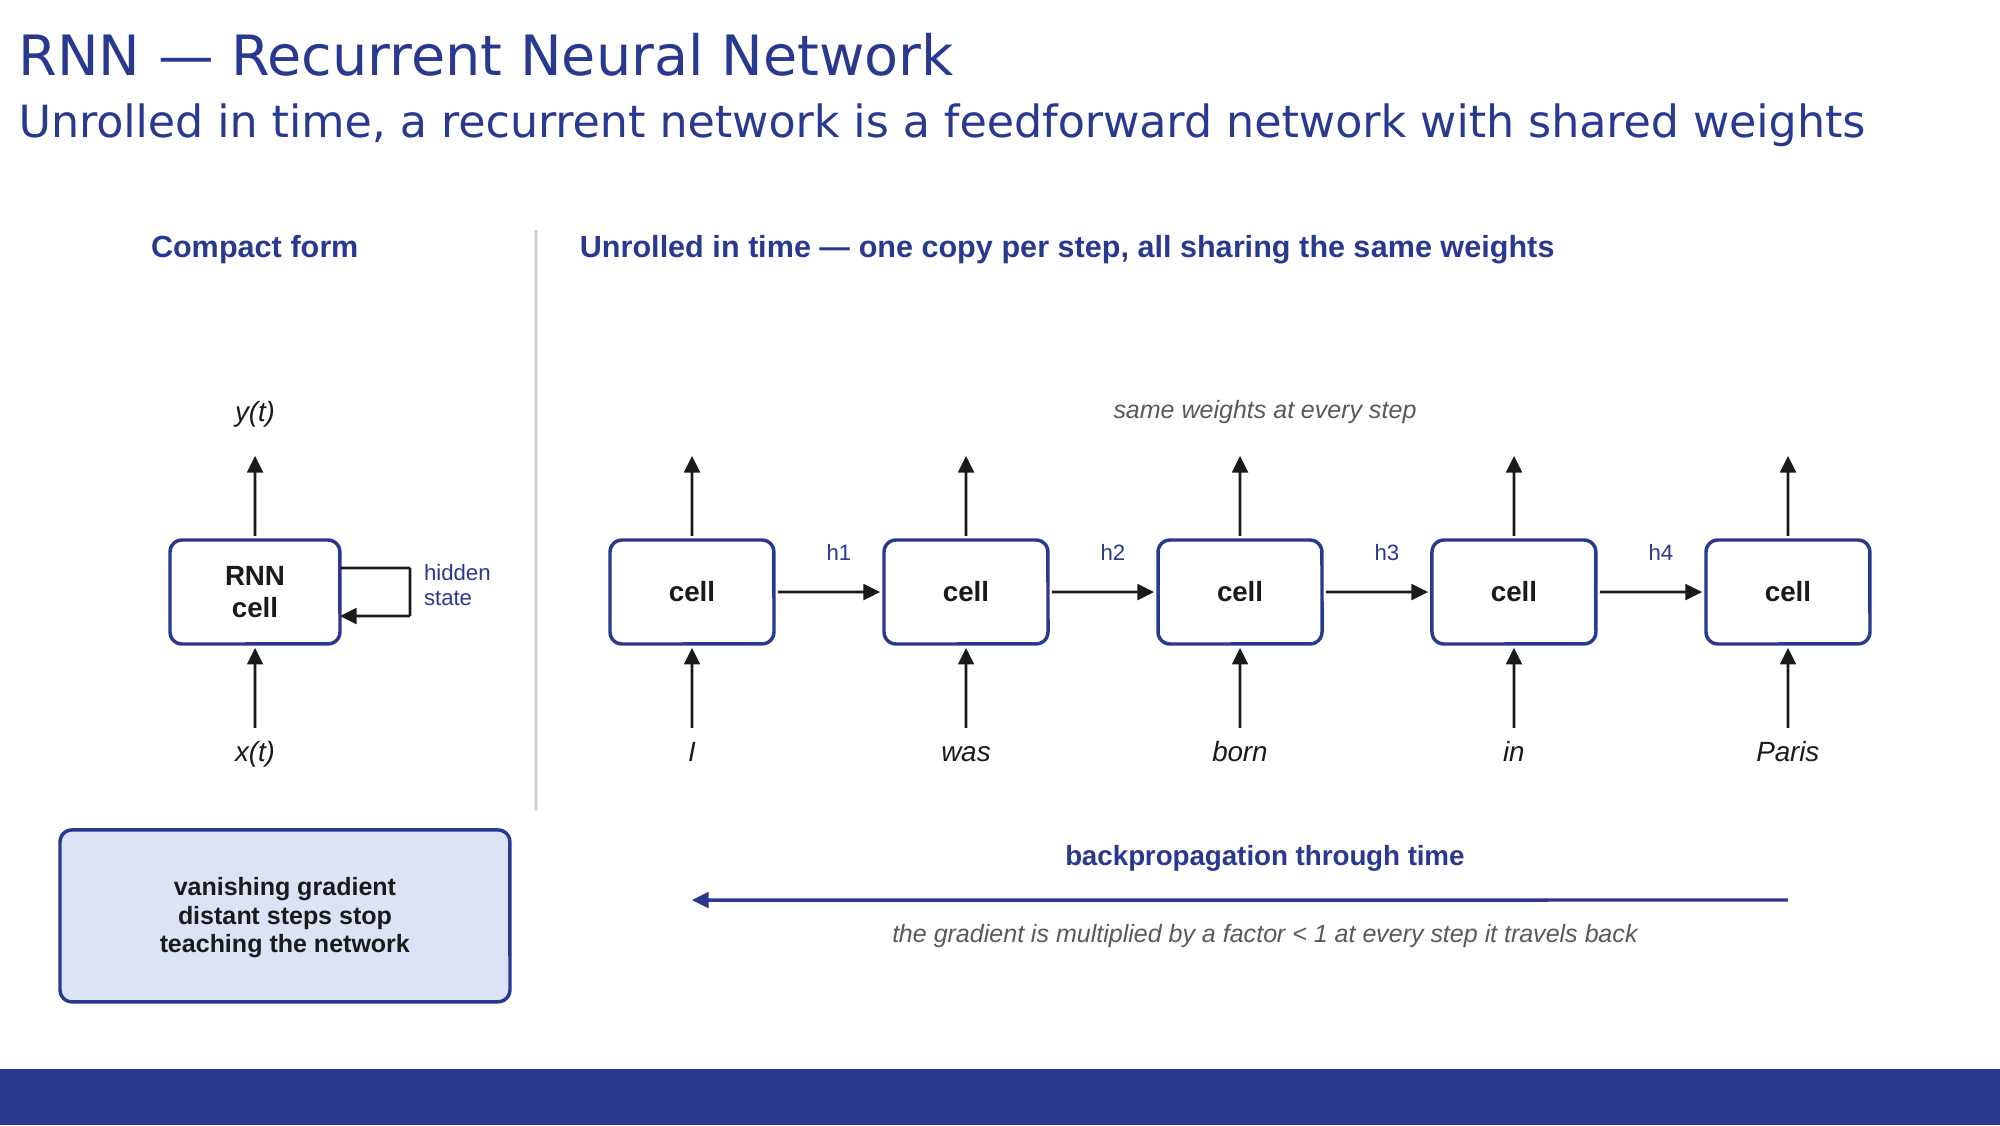
RNN, Recurrent Neural Network. Nasce per un problema opposto rispetto alla CNN: dati sequenziali, dove l’ordine conta, come il testo o le serie temporali. L’idea chiave è l’anello di retroazione: a differenza di una rete feedforward, dove l’informazione scorre solo in avanti, in una RNN la rete tiene uno stato interno che a ogni passo torna indietro e le viene ridato in pasto insieme all’elemento successivo della sequenza. Quello stato che rientra si chiama stato nascosto, ed è distinto dall’output vero e proprio, che a ogni passo se ne ricava: poiché lo stato nascosto dipende dalla parola corrente e dallo stato nascosto del passo precedente, che a sua volta dipendeva dalla parola ancora prima, e così via a ritroso, finisce per essere funzione di tutte le parole lette fino a quel momento.
Per capire come si allena, conviene immaginare di srotolare la rete nel tempo: invece di un’unica cella che si richiama da sola, la si ridisegna come una rete feedforward con tanti strati quanti sono i passi della sequenza, ognuno una copia della stessa cella, che riceve in input la parola di quell’istante insieme allo stato nascosto dello strato precedente. Vista così, la RNN è semplicemente una feedforward con i pesi condivisi tra tutti gli strati, e l’addestramento usa esattamente la stessa backpropagation del capitolo 8, solo che gli strati sono diventati istanti temporali: per questo si chiama backpropagation through time.
Ed è proprio qui che nasce il limite principale. A ogni strato che attraversa all’indietro, il gradiente viene moltiplicato per un fattore tipicamente minore di uno, e moltiplicando tanti numeri minori di uno tra loro, dopo poche decine di passi il gradiente si azzera praticamente del tutto: la rete smette di imparare dalle informazioni lontane nel passato, e il suo comportamento finisce per dipendere quasi solo dagli ultimi elementi della sequenza. Questo perché l’aggiornamento dei pesi è la somma dei contributi che arrivano da tutti i passi della sequenza: se il contributo legato a un’informazione lontana è praticamente zero, i pesi continuano ad aggiornarsi, ma solo in base a ciò che è successo negli ultimi passi. Le dipendenze lontane, semplicemente, smettono di insegnare qualcosa alla rete. È il cosiddetto vanishing gradient, e sono nate varianti come LSTM, Long Short-Term Memory, e GRU, Gated Recurrent Unit, apposta per attenuarlo: invece di riscrivere tutto lo stato nascosto a ogni passo, introducono dei gate che decidono esplicitamente cosa trattenere e cosa lasciar perdere dell’informazione precedente, così il segnale rilevante può attraversare molti passi senza affievolirsi*. Ed è proprio questo limite strutturale ad aprire la strada al prossimo capitolo.
*I gate non sono regole scritte a mano, sono a loro volta piccoli strati con pesi propri, appresi durante l’addestramento con la stessa backpropagation through time.
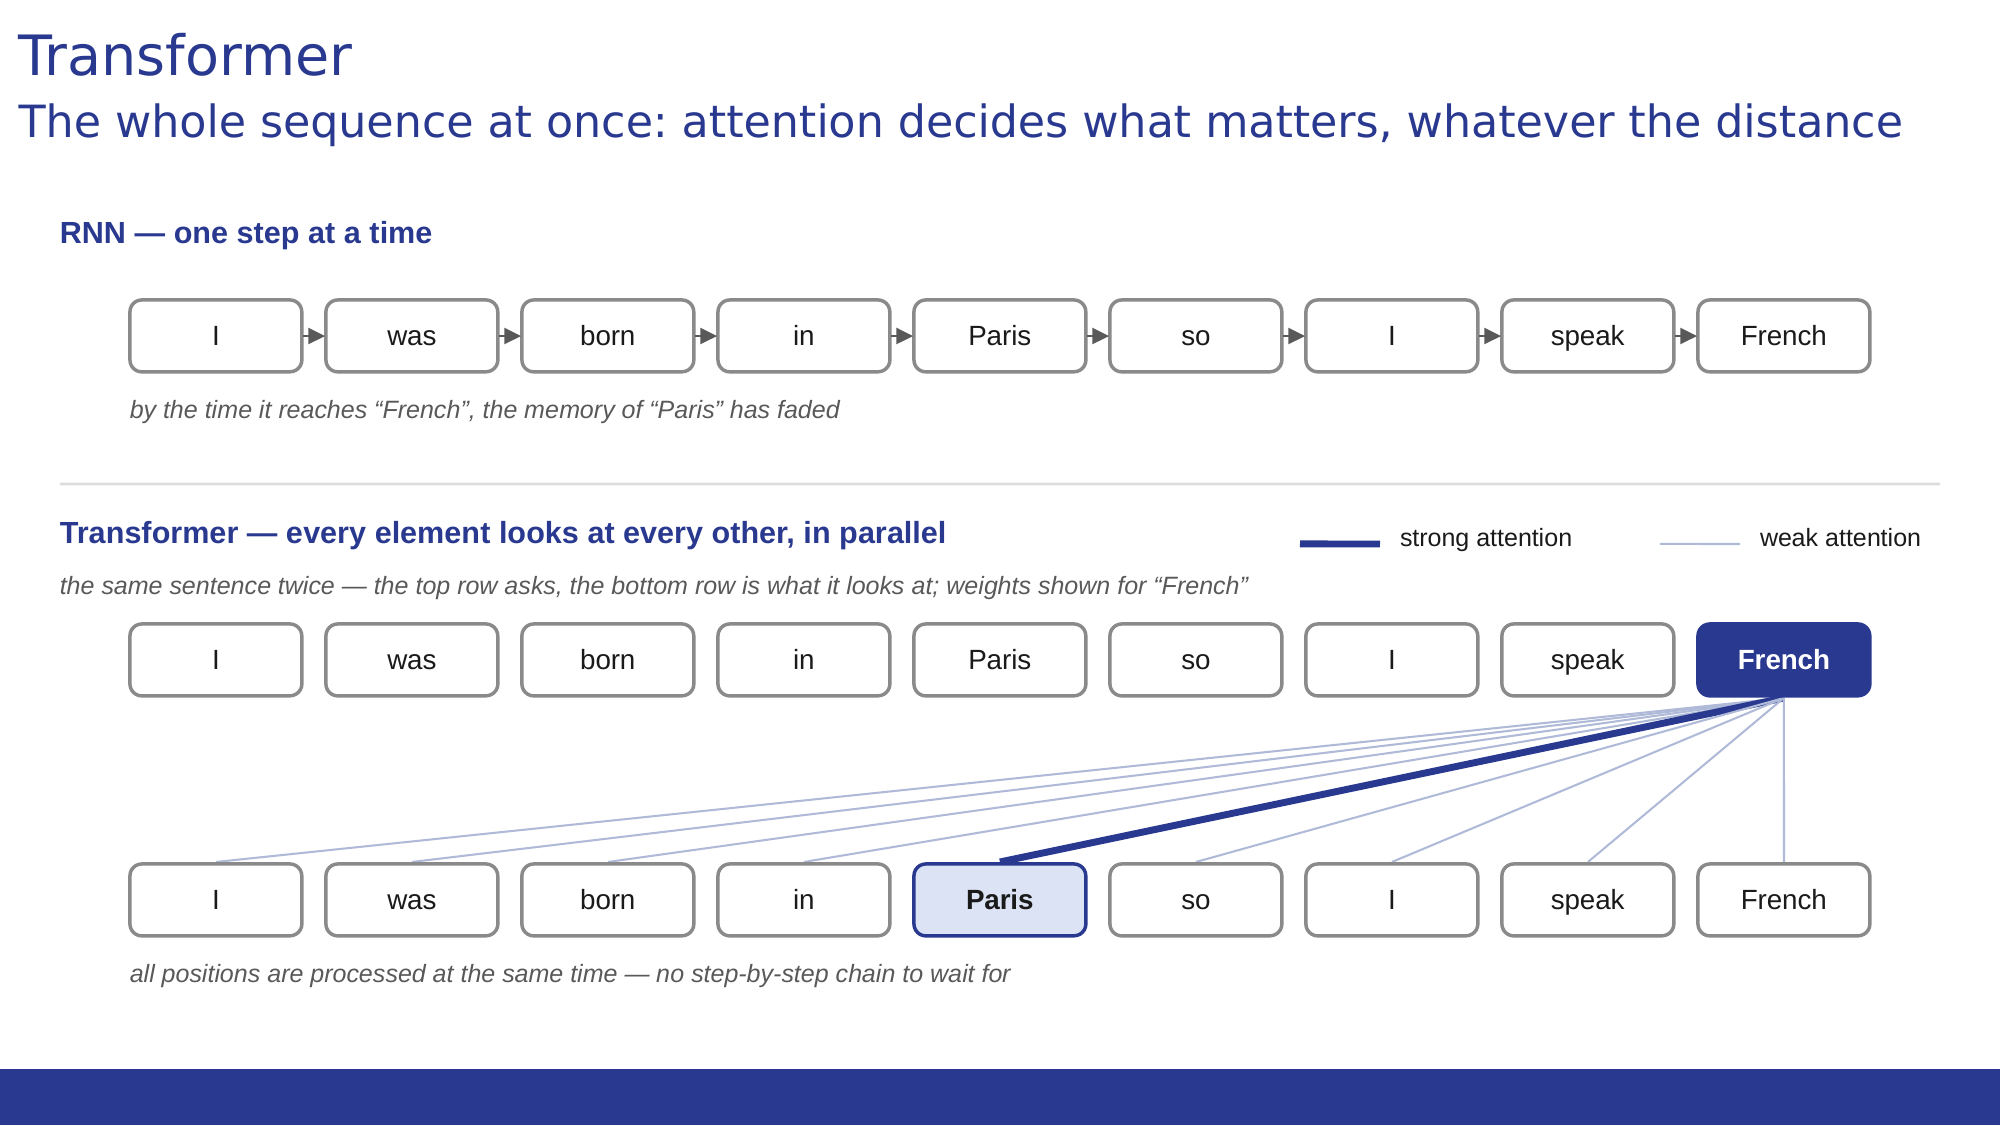
Transformer. Nasce proprio per superare il collo di bottiglia della RNN: leggere un elemento alla volta. Invece di scorrere la frase parola dopo parola, portandosi dietro una sintesi che si sfalda con la distanza, il Transformer guarda tutte le posizioni contemporaneamente e, per ogni parola, calcola quanto ciascuna delle altre conti per interpretarla. È il meccanismo chiamato attenzione.
Il guadagno è doppio. Primo: una dipendenza lontana non è più una lunga catena da risalire. Se la parola francese dipende dalla parola Parigi, qualche posizione prima, l’attenzione le collega direttamente, in un solo passaggio, e il problema del vanishing gradient non si presenta nella stessa forma. Secondo, ed è ciò che ha cambiato la storia del settore: calcolare tutte le posizioni insieme è un’operazione che una GPU può parallelizzare massicciamente, quindi l’addestramento scala su quantità di testo impensabili per una rete ricorrente.
È l’architettura su cui è costruito praticamente ogni large language model oggi in uso, ed è il tema della Serie 4, dove lo apriremo e lo vedremo componente per componente. Per ora basta una frase: anche il Transformer legge sequenze, ma tutte in una volta invece che un passo alla volta.
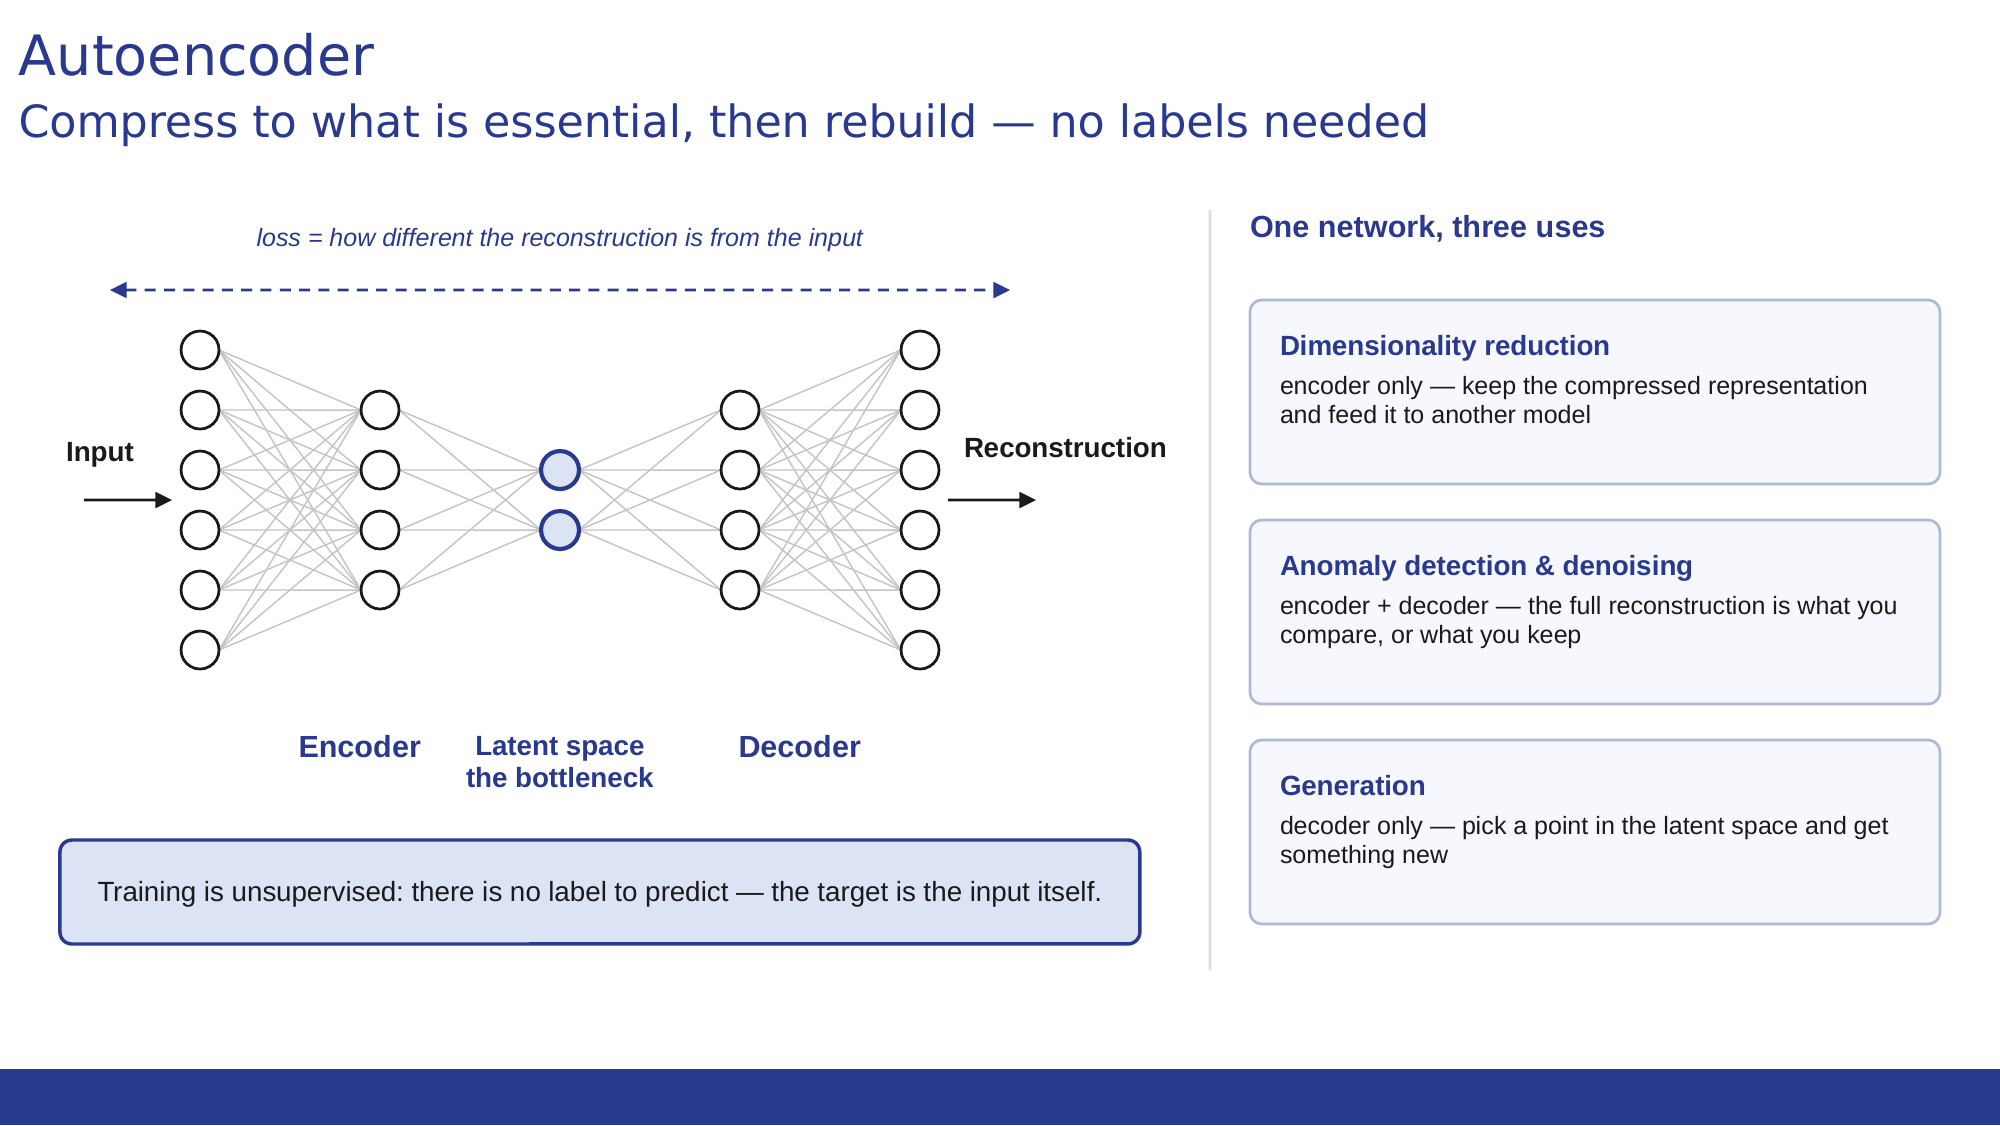
Autoencoder. È una rete che nasce per l’apprendimento non supervisionato, e la sua struttura è particolare: comprime l’input in una rappresentazione a bassa dimensione, chiamata spazio latente o bottleneck, e poi cerca di ricostruire l’input originale a partire da quella rappresentazione compressa. La prima metà, che comprime, si chiama encoder, la seconda, che ricostruisce, decoder. Nel capitolo 9 avevamo incontrato l’autoencoder sparso, che faceva l’opposto, espandeva poche dimensioni sovraffollate in uno spazio più ampio per rendere le feature più leggibili: qui l’operazione centrale è quella originaria, comprimere e poi ricostruire.
Non essendoci etichette, l’obiettivo di addestramento è semplicemente che l’output ricostruito sia il più simile possibile all’input originale: la loss misura la differenza tra i due. Proprio perché la rete è costretta a passare per quel collo di bottiglia, è obbligata a imparare quali caratteristiche dell’input siano davvero essenziali per ricostruirlo, scartando il rumore.
Una volta addestrata la rete, l’encoder e il decoder possono anche essere separati e usati per conto proprio. Il decoder da solo diventa un generatore: partendo da un punto nello spazio latente produce un output nuovo. In un autoencoder semplice funziona però solo fino a un certo punto, perché lo spazio latente non è organizzato per questo e un punto scelto a caso può ricostruirsi in qualcosa che non significa nulla: sono gli autoencoder variazionali a sistemare proprio questo, ed è da lì che l’idea si collega al filone dei modelli generativi.
Gli ambiti principali, di conseguenza, si dividono per come usano le due metà. Nella riduzione di dimensionalità si usa solo l’encoder: tutto ciò che serve è la rappresentazione compressa, per esempio le poche dimensioni che sintetizzano centinaia di caratteristiche di un cliente, da passare a un altro modello come un sistema di raccomandazione. Nel rilevamento di anomalie e nel denoising, invece, si usano encoder e decoder insieme, perché in entrambi i casi serve la ricostruzione completa: nel primo caso per confrontarla con l’input originale, come nel monitoraggio di transazioni con carta di credito, dove un input anomalo si ricostruisce peggio del normale; nel secondo per restituire in uscita una versione pulita dell’input rumoroso, come nella diagnostica per immagini, dove l’autoencoder impara a restituire una risonanza più nitida.
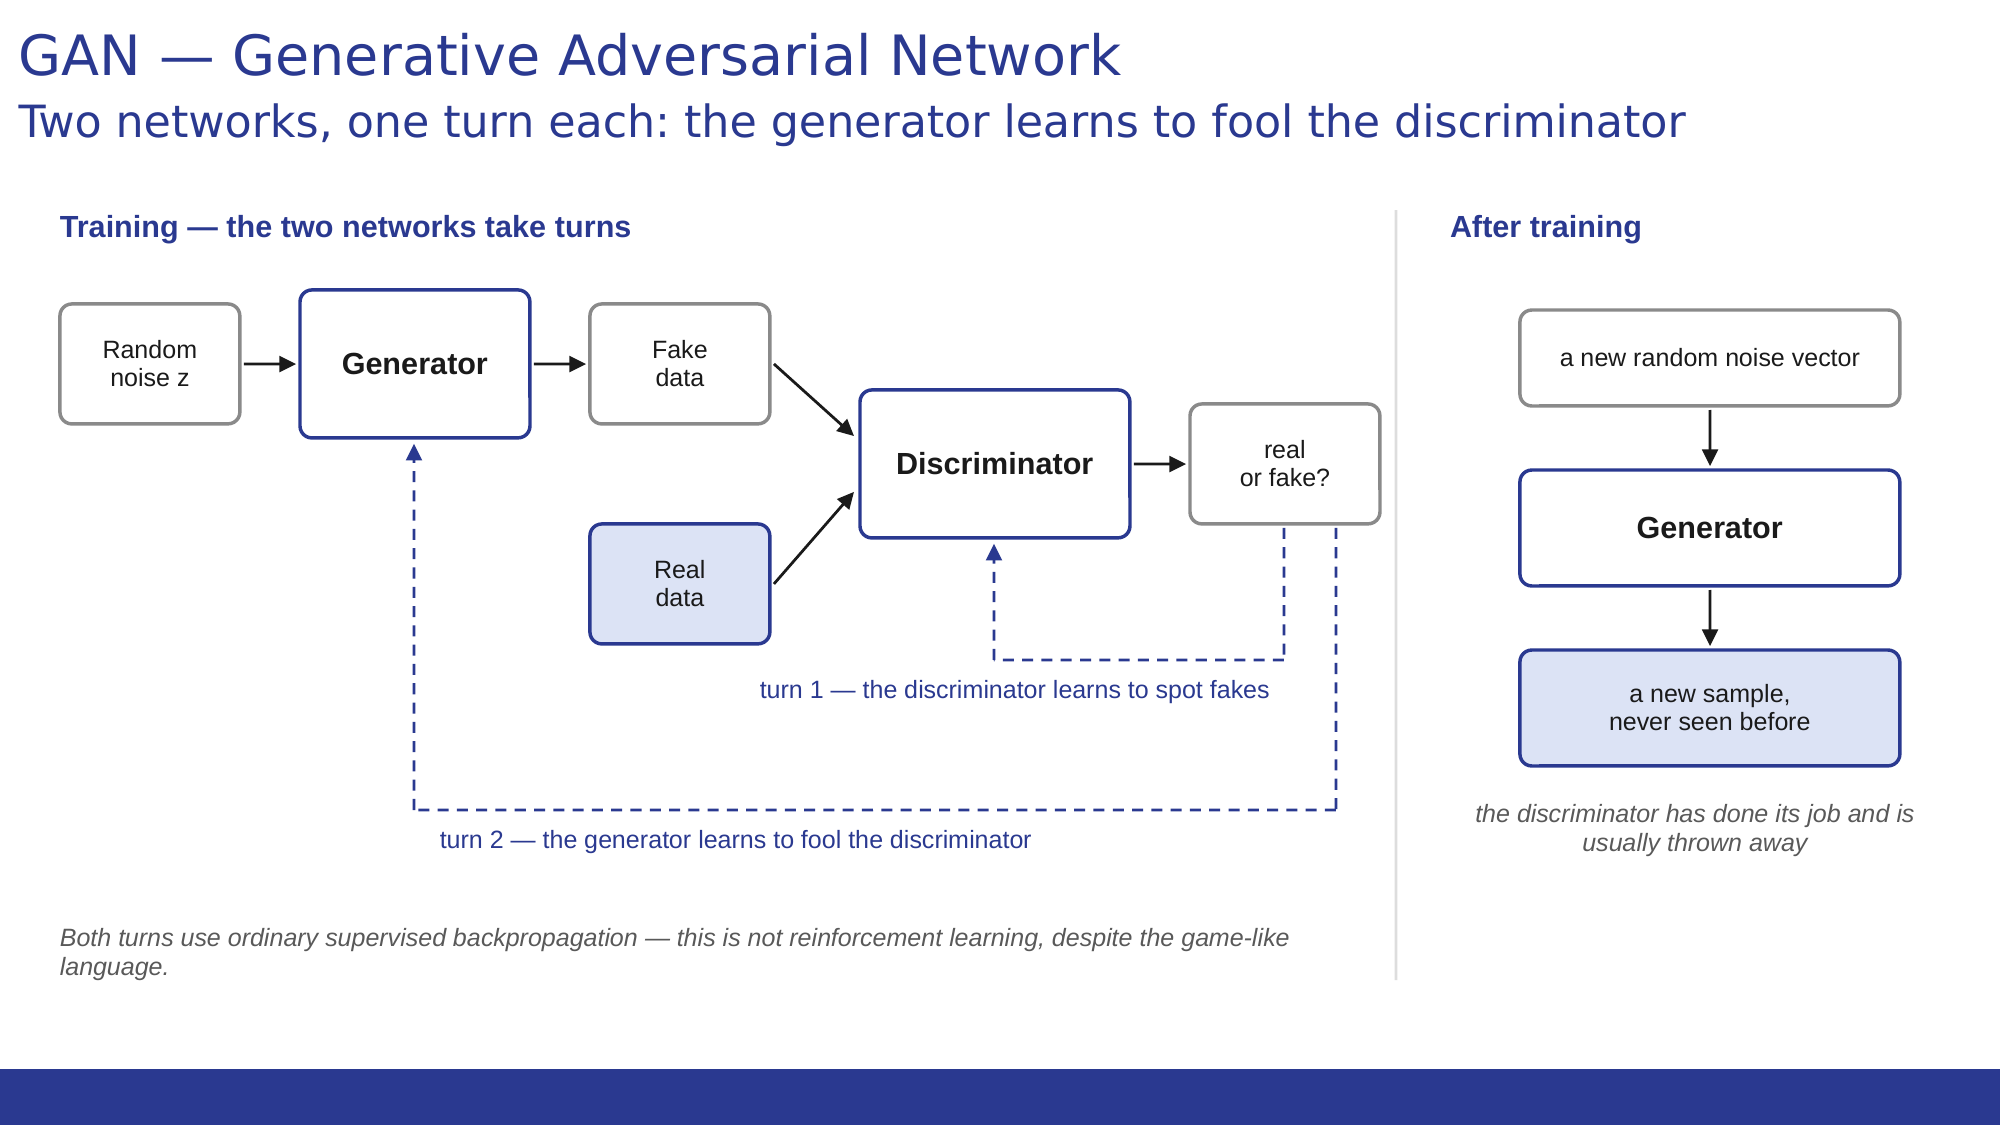
GAN, Generative Adversarial Network. È composta da due reti distinte che si allenano l’una contro l’altra: il generatore e il discriminatore. Il generatore parte da rumore casuale e cerca di produrre dati falsi che sembrino veri, per esempio immagini; il discriminatore riceve sia dati veri che dati falsi prodotti dal generatore, e deve imparare a distinguerli.
L’addestramento procede a turni. A ogni ciclo, prima si allena il discriminatore: gli si mostrano esempi reali, etichettati come veri, ed esempi appena prodotti dal generatore, etichettati come falsi, e si aggiustano i suoi pesi con la normale backpropagation perché impari a riconoscerli. Poi si allena il generatore: gli si fa produrre nuovi dati falsi, si passano al discriminatore, ma questa volta la loss del generatore misura quanto bene sia riuscito a farli passare per veri, quindi i suoi pesi vengono aggiustati nella direzione che massimizza l’errore del discriminatore. Le due reti giocano quindi un gioco a somma pressoché zero, finché il generatore diventa capace di produrre dati praticamente indistinguibili da quelli reali.
Vale la pena una precisazione: questo schema a due agenti in competizione ricorda per certi versi il reinforcement learning del capitolo 5, e non a caso viene spesso descritto con un linguaggio simile, gioco a somma zero, equilibrio, strategia. Ma dal punto di vista dell’algoritmo resta un apprendimento supervisionato applicato due volte: sia generatore che discriminatore vengono aggiornati con la normale backpropagation su una loss differenziabile, non con ricompense e policy.
Una volta completato l’addestramento, si usa quasi sempre solo il generatore: gli si dà in input un nuovo vettore di rumore casuale, diverso ogni volta, e lui restituisce un’immagine nuova, mai vista, coerente con lo stile dei dati su cui si è allenato. Il discriminatore viene di norma scartato, e trova impiego solo in contesti specifici, come il rilevamento di contenuti sintetici. Nella sua forma base, inoltre, non si può chiedere al generatore qualcosa di specifico: ogni output nasce da un punto scelto a caso nello spazio del rumore. Esistono varianti pensate apposta per questo, come le GAN condizionali, dove al rumore si affianca un’etichetta di controllo vista da entrambe le reti durante l’addestramento.
Gli ambiti principali sono la generazione di immagini e video realistici, il trasferimento di stile, e l’aumento artificiale di dataset quando i dati reali sono scarsi. Con l’avvento dei modelli di diffusione, di cui parleremo nel capitolo 30, le GAN hanno perso terreno nella generazione di immagini da testo, ma restano competitive in nicchie dove contano velocità e costo computazionale, come l’upscaling o il trasferimento di stile in tempo reale.
Con queste cinque famiglie il catalogo delle architetture di base è completo, e con esso anche la Serie 2. Resta però un vincolo che abbiamo già incontrato e mai risolto davvero: una rete neurale, qualunque sia la sua topologia, parla solo il linguaggio dei numeri. Se voglio che una CNN veda un’immagine o un Transformer legga una frase, quell’immagine e quella frase devono prima diventare numeri, e non numeri qualsiasi: numeri che portino con sé un significato. È la domanda con cui si apre la prossima serie: può un numero significare davvero qualcosa?