Il capitolo 11 si chiudeva con un punto aperto: nella realtà, il significato associato alle dimensioni di uno spazio denso non viene definito a priori, ma viene appreso durante l’addestramento. È il momento di vedere come.
Prima di Word2Vec, un modo abbastanza naturale di costruire rappresentazioni dense era contare: si scorre un grande corpus di testo e si annota, per ogni parola, quante volte compare vicino a ciascuna altra parola. Il risultato è una matrice di co-occorrenza, in cui la riga di una parola è già, in un certo senso, un vettore che ne descrive il comportamento nel testo. La matrice, però, diventa rapidamente ingestibile con la crescita della dimensione del vocabolario, e va ridotta con tecniche successive per diventare uno spazio denso maneggevole. E funziona male anche su parole come articoli e congiunzioni, che compaiono vicino a moltissime parole diverse e finiscono per assomigliare a tutto e a niente.
Dietro il conteggio delle co-occorrenze, e dietro Word2Vec, c’è la stessa idea di fondo, formulata dal linguista John Firth nel 1957: si conosce una parola dalla compagnia che frequenta. Due parole che compaiono spesso negli stessi contesti tendono ad avere significati simili. È un’ipotesi elegante perché trasforma un problema che sembrava richiedere una comprensione del significato in un problema molto più trattabile: guardare quali parole stanno vicine a quali altre.
Word2Vec, proposto da Mikolov e colleghi in un paper del 2013 targato Google, Efficient Estimation of Word Representations in Vector Space, prende questa idea e la trasforma in un compito di addestramento vero e proprio, risolvibile con una rete neurale. Esistono due varianti complementari, che differiscono solo per come è impostato il compito di predizione: continuous bag of words, o CBOW, e skip-gram. Ci concentriamo qui sulla prima, ma l’idea di fondo è la stessa per entrambe.
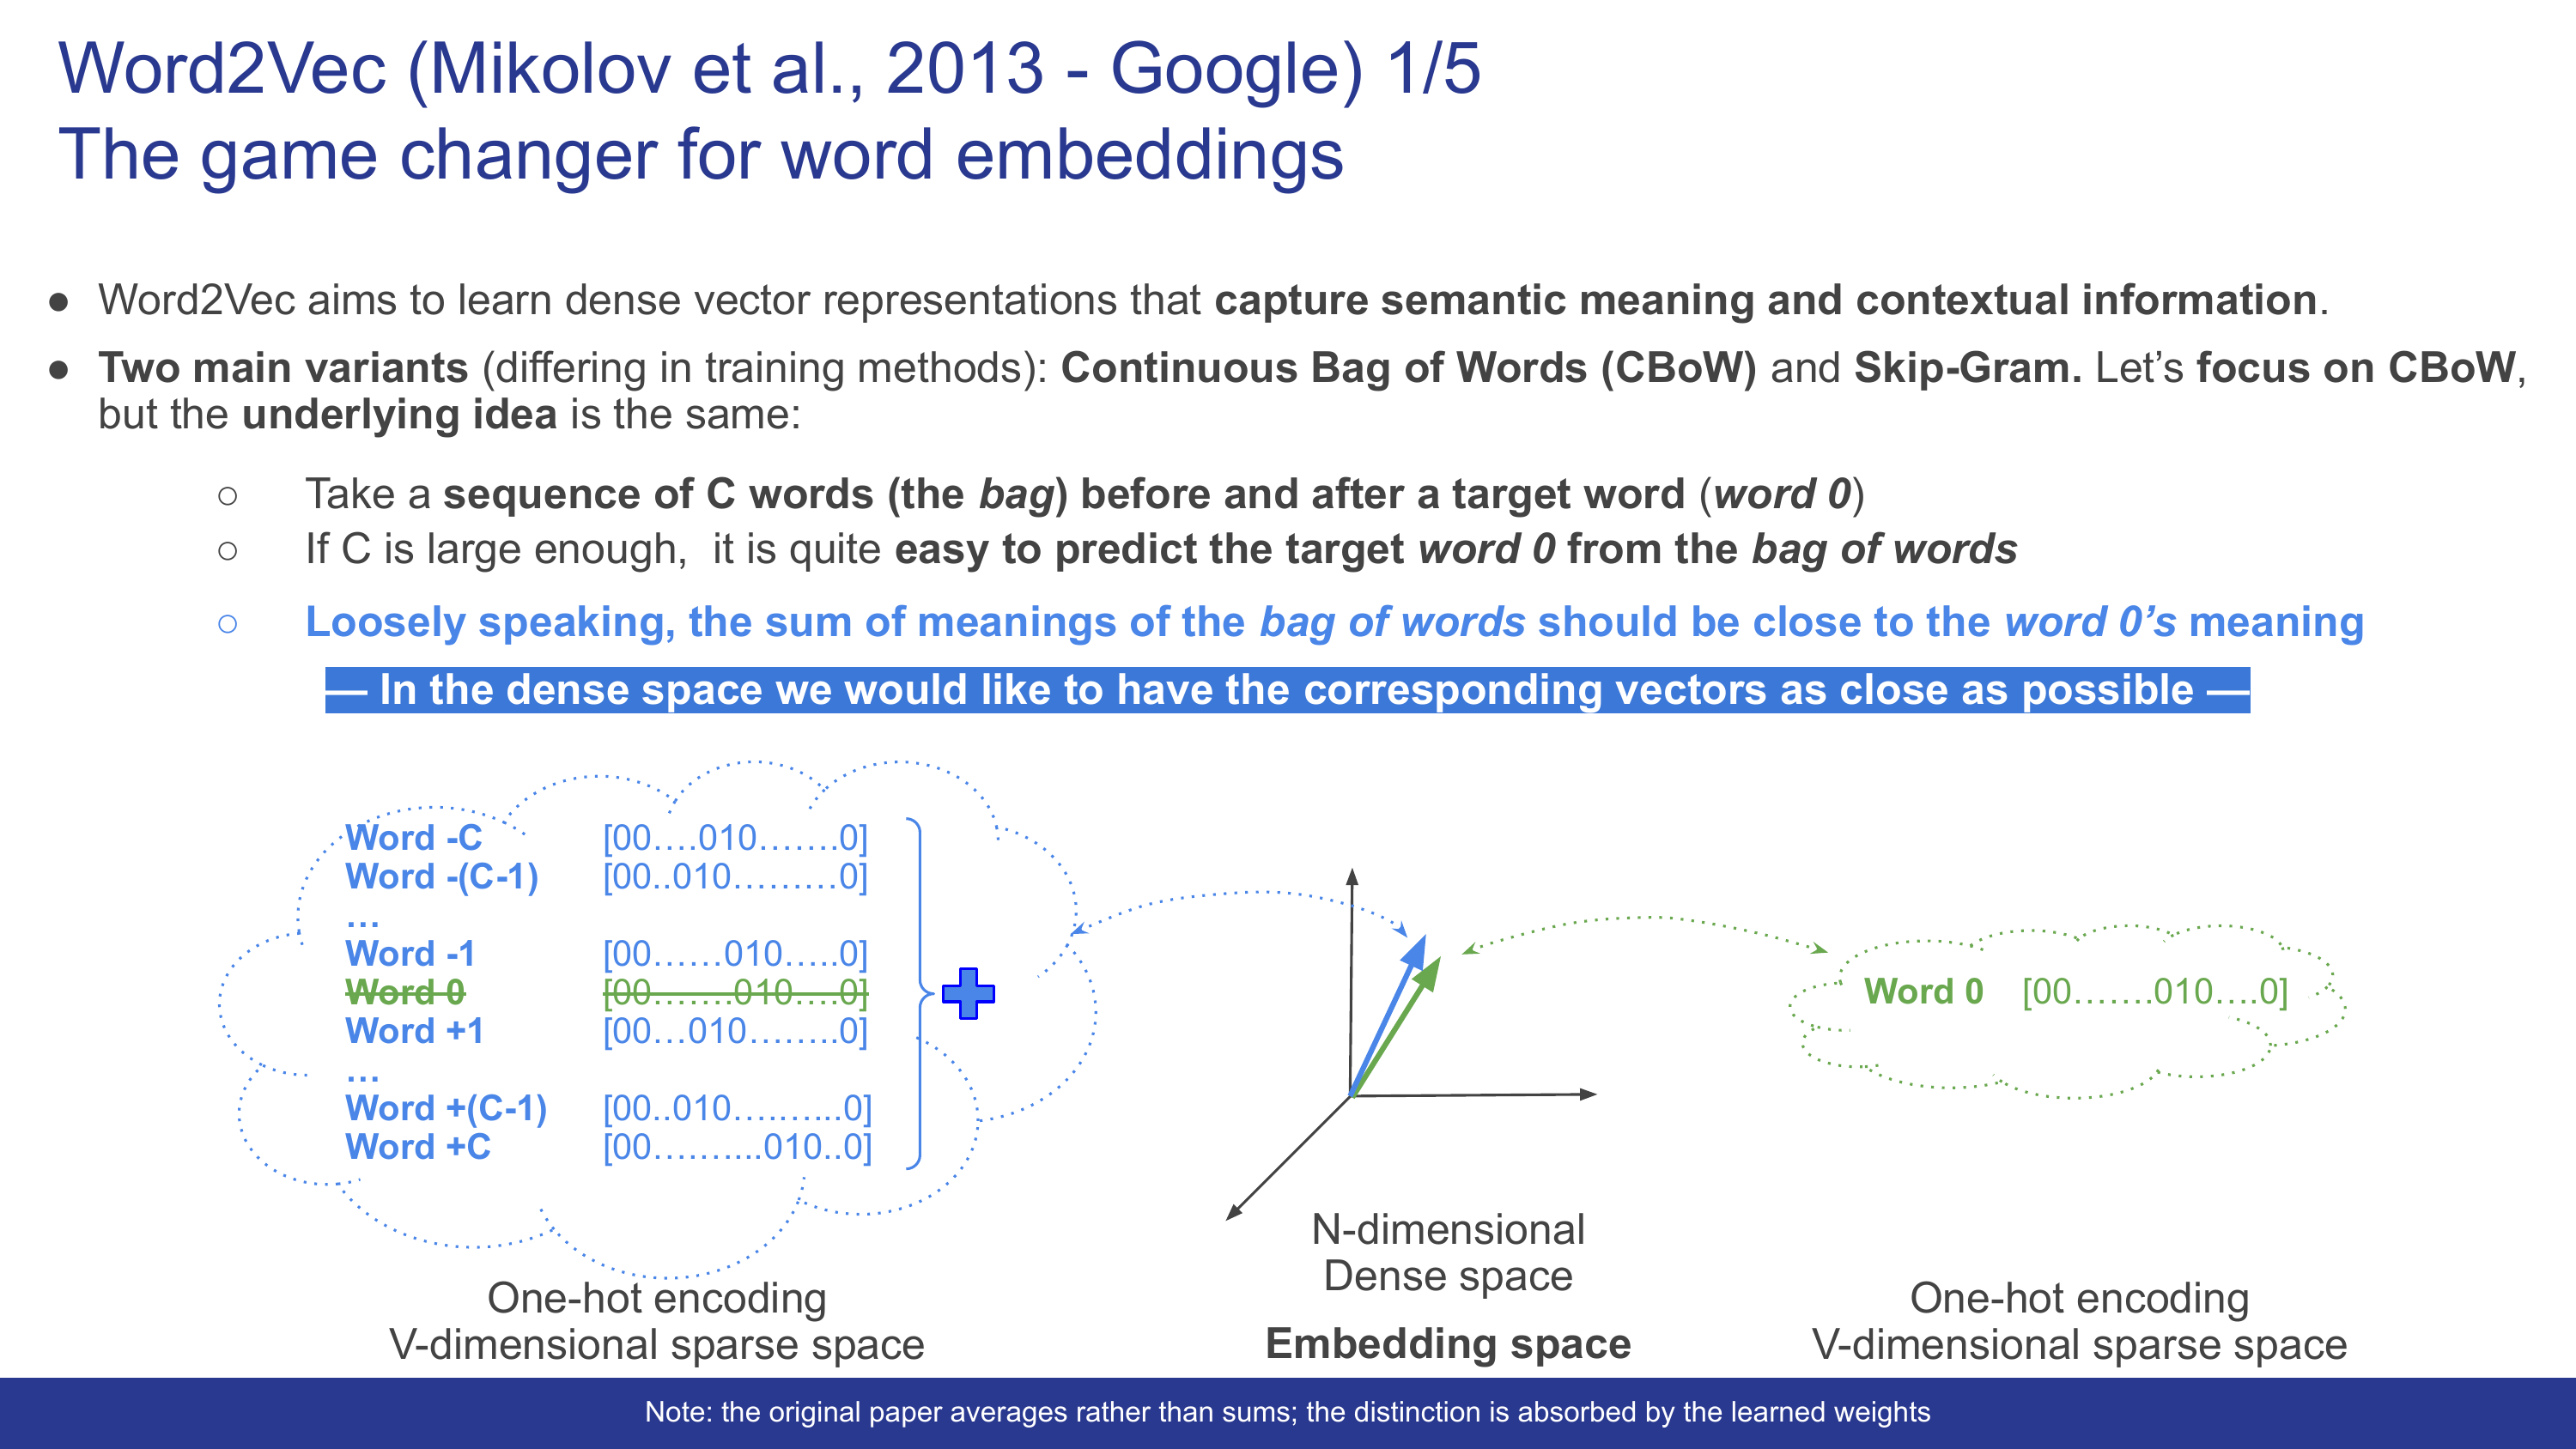
L’idea del continuous bag of words è a suo modo intuitiva, e nasce dall’esperienza comune: se prendiamo un testo qualunque e ne consideriamo una finestra sufficientemente lunga, e cancelliamo la parola al centro di una sequenza di C parole prima e C parole dopo, è abbastanza facile indovinare quale sia la parola mancante. Da questa idea nasce il compito di predizione: data una sequenza di 2C + 1 parole — le C parole prima della parola target e le C parole dopo — indovinare la parola mancante. Detto in modo un po’ libero, l’obiettivo è costruire uno spazio in cui la somma delle rappresentazioni vettoriali delle parole di contesto, le C prima e le C dopo, risulti quanto più vicina possibile alla rappresentazione vettoriale della parola target. (Il paper originale, a rigore, fa la media invece della somma: è una differenza che i pesi appresi riassorbono da sé.)
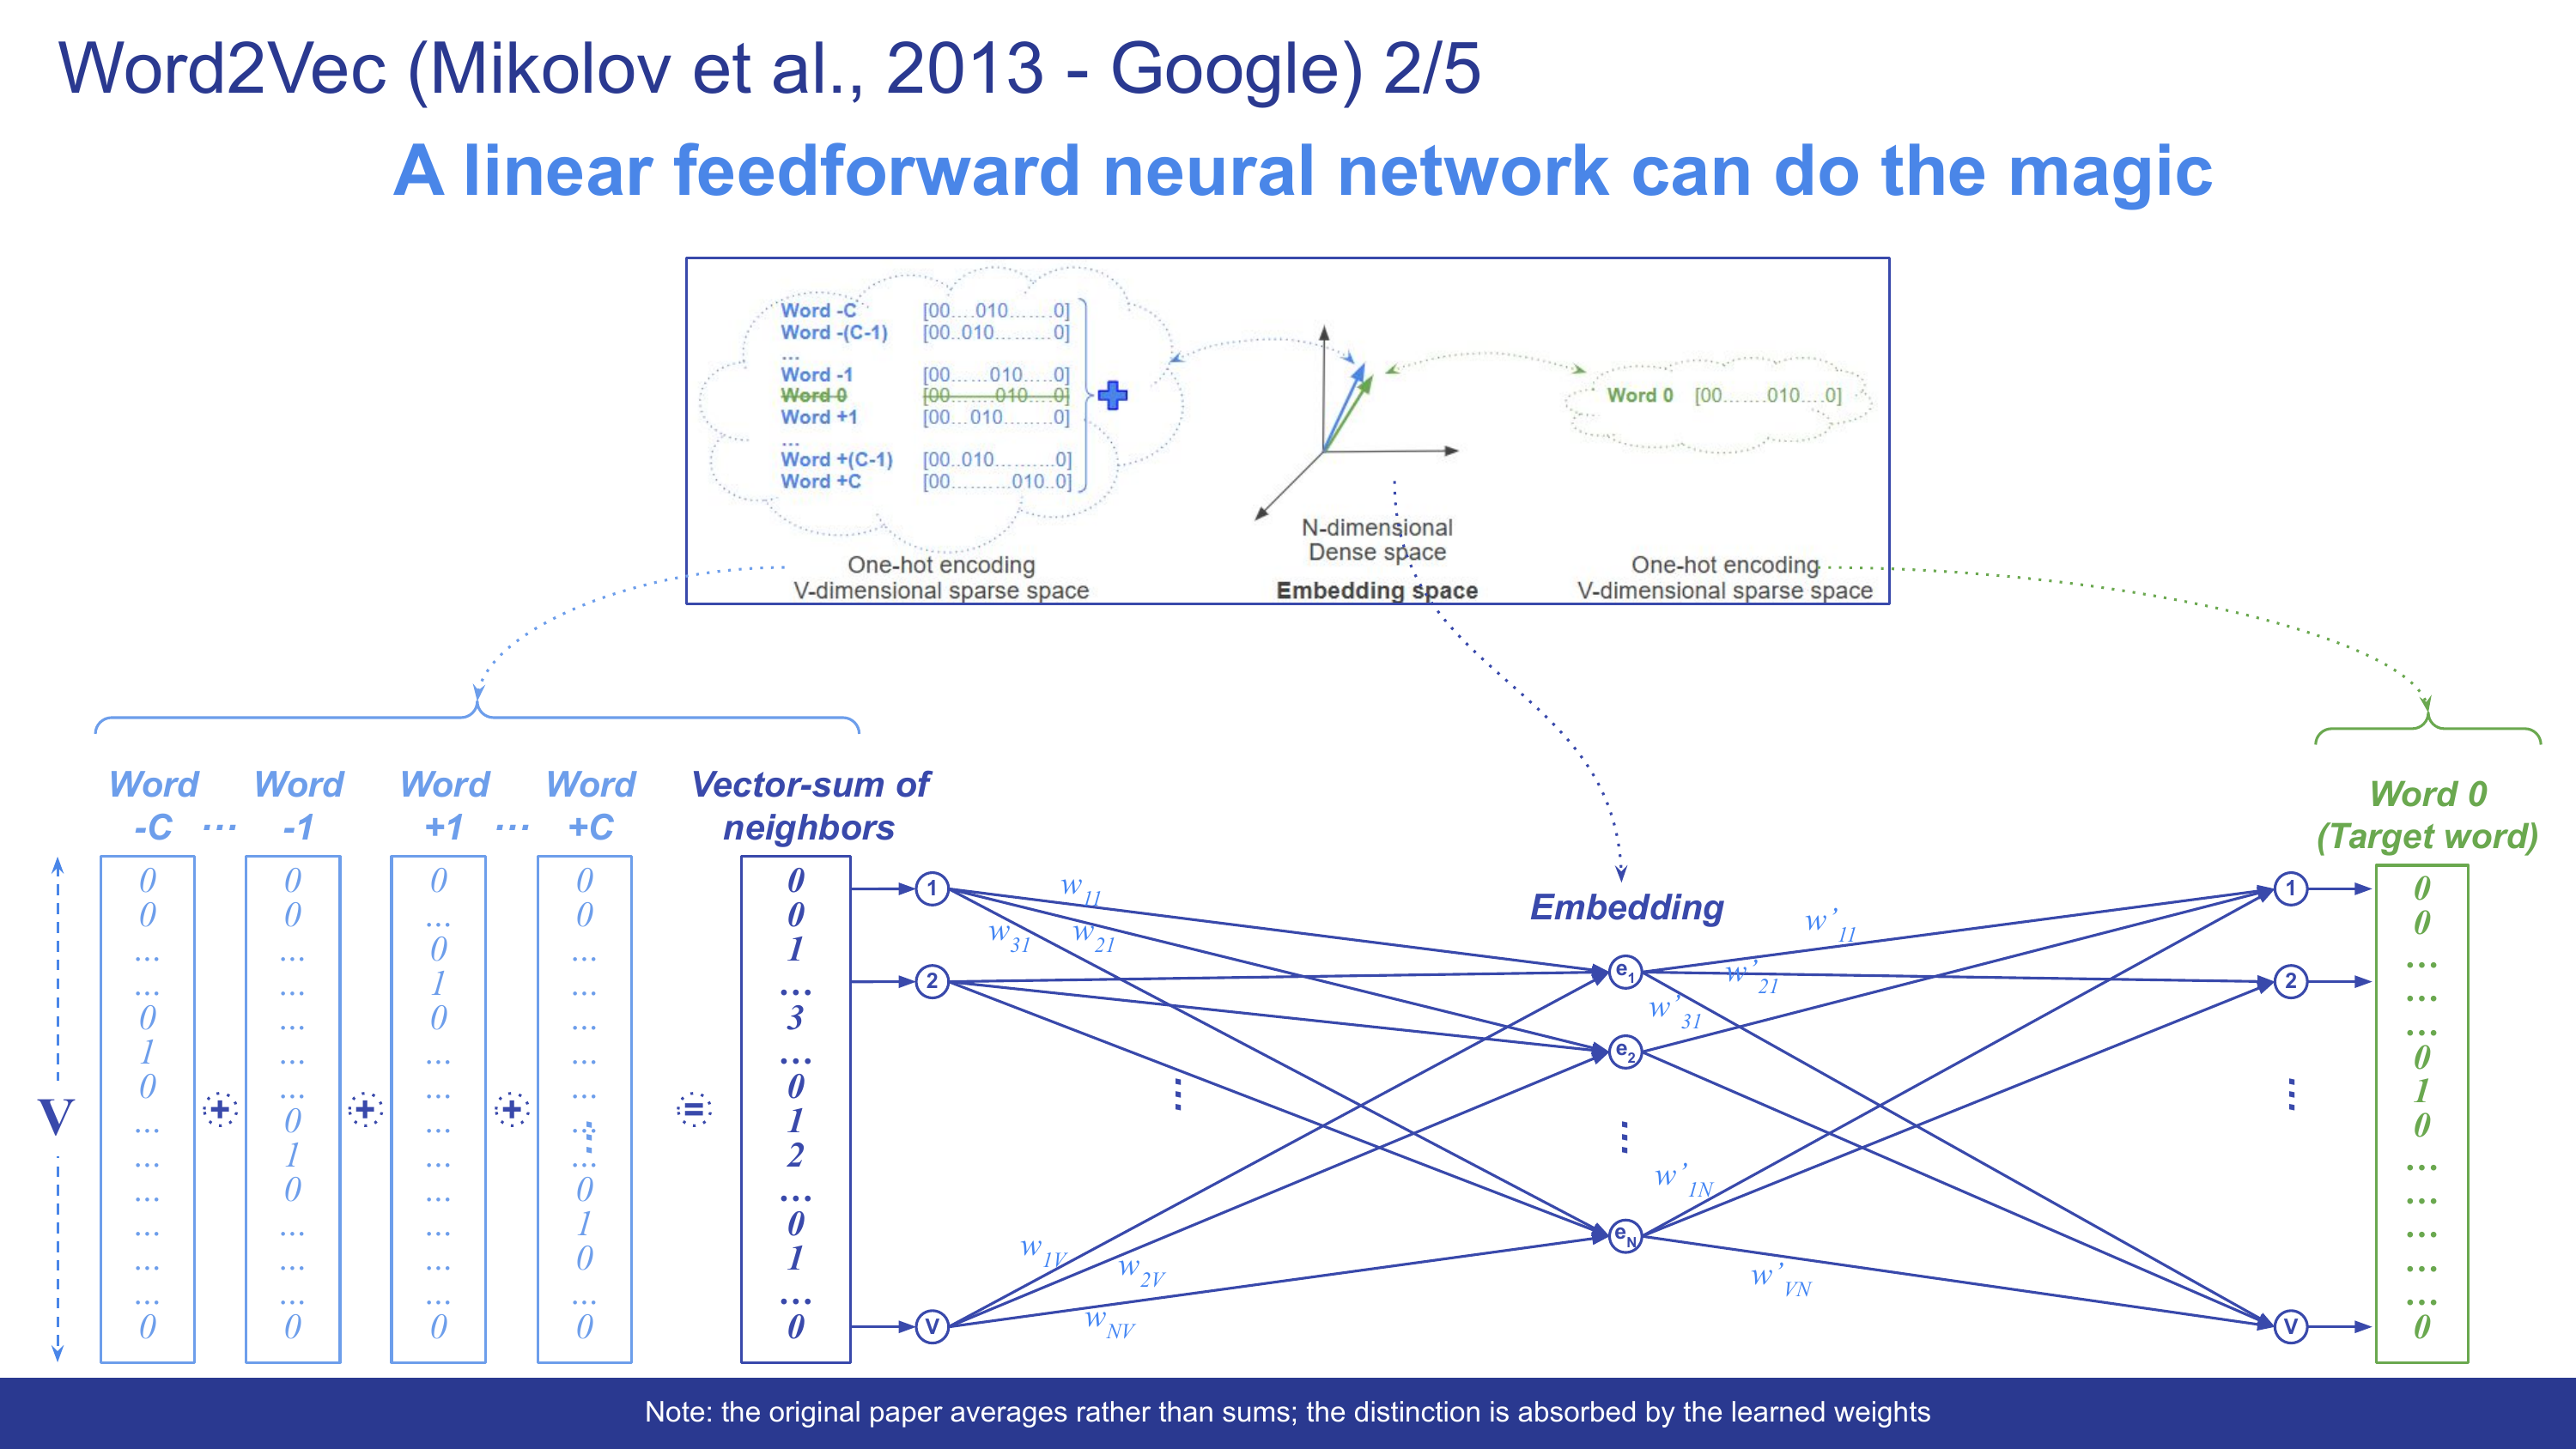
Quel compito si può risolvere con una rete feedforward semplicissima, con un solo strato nascosto: uno strato di input, che riceve la somma dei vettori di contesto; uno strato nascosto, di dimensione molto più piccola del vocabolario; uno strato di output, largo di nuovo quanto il vocabolario, che assegna un punteggio a ogni parola: l’addestramento lo spinge ad assomigliare il più possibile al one-hot della parola target. La forma è quella a clessidra dell’autoencoder del capitolo 10 — input largo, collo di bottiglia stretto, output di nuovo largo — e in un certo senso anche l’obiettivo ricorda quello di un autoencoder: si vuole che l’output finale assomigli quanto più possibile a una rappresentazione coerente con l’input, anche se qui l’input è la somma dei contesti e l’output è la parola target, non lo stesso identico oggetto. Non è un autoencoder in senso tecnico, come quello del capitolo 10, ma ne condivide sia la forma sia lo spirito. Esattamente come nel capitolo 7, ogni strato è una somma pesata che attraversa una matrice di parametri: la matrice W collega input e strato nascosto, la matrice W’ collega strato nascosto e output. Con una differenza importante, però: qui non c’è nessuna funzione di attivazione, la rete è deliberatamente lineare, e quindi — come avevamo visto proprio nel capitolo 7 — le due matrici si potrebbero moltiplicare una volta per tutte e ridurre a una sola. Non è un difetto: qui il lavoro non lo fa la profondità, lo fa la strettoia. Lo strato nascosto è molto più piccolo del vocabolario e obbliga tutto a passare per poche dimensioni; è quella compressione forzata a produrre l’embedding. La dimensione di quello strato nascosto è, di fatto, la dimensione dello spazio denso che stiamo costruendo, ed è una dimensione che scegliamo noi, non qualcosa che il modello decide da sé.
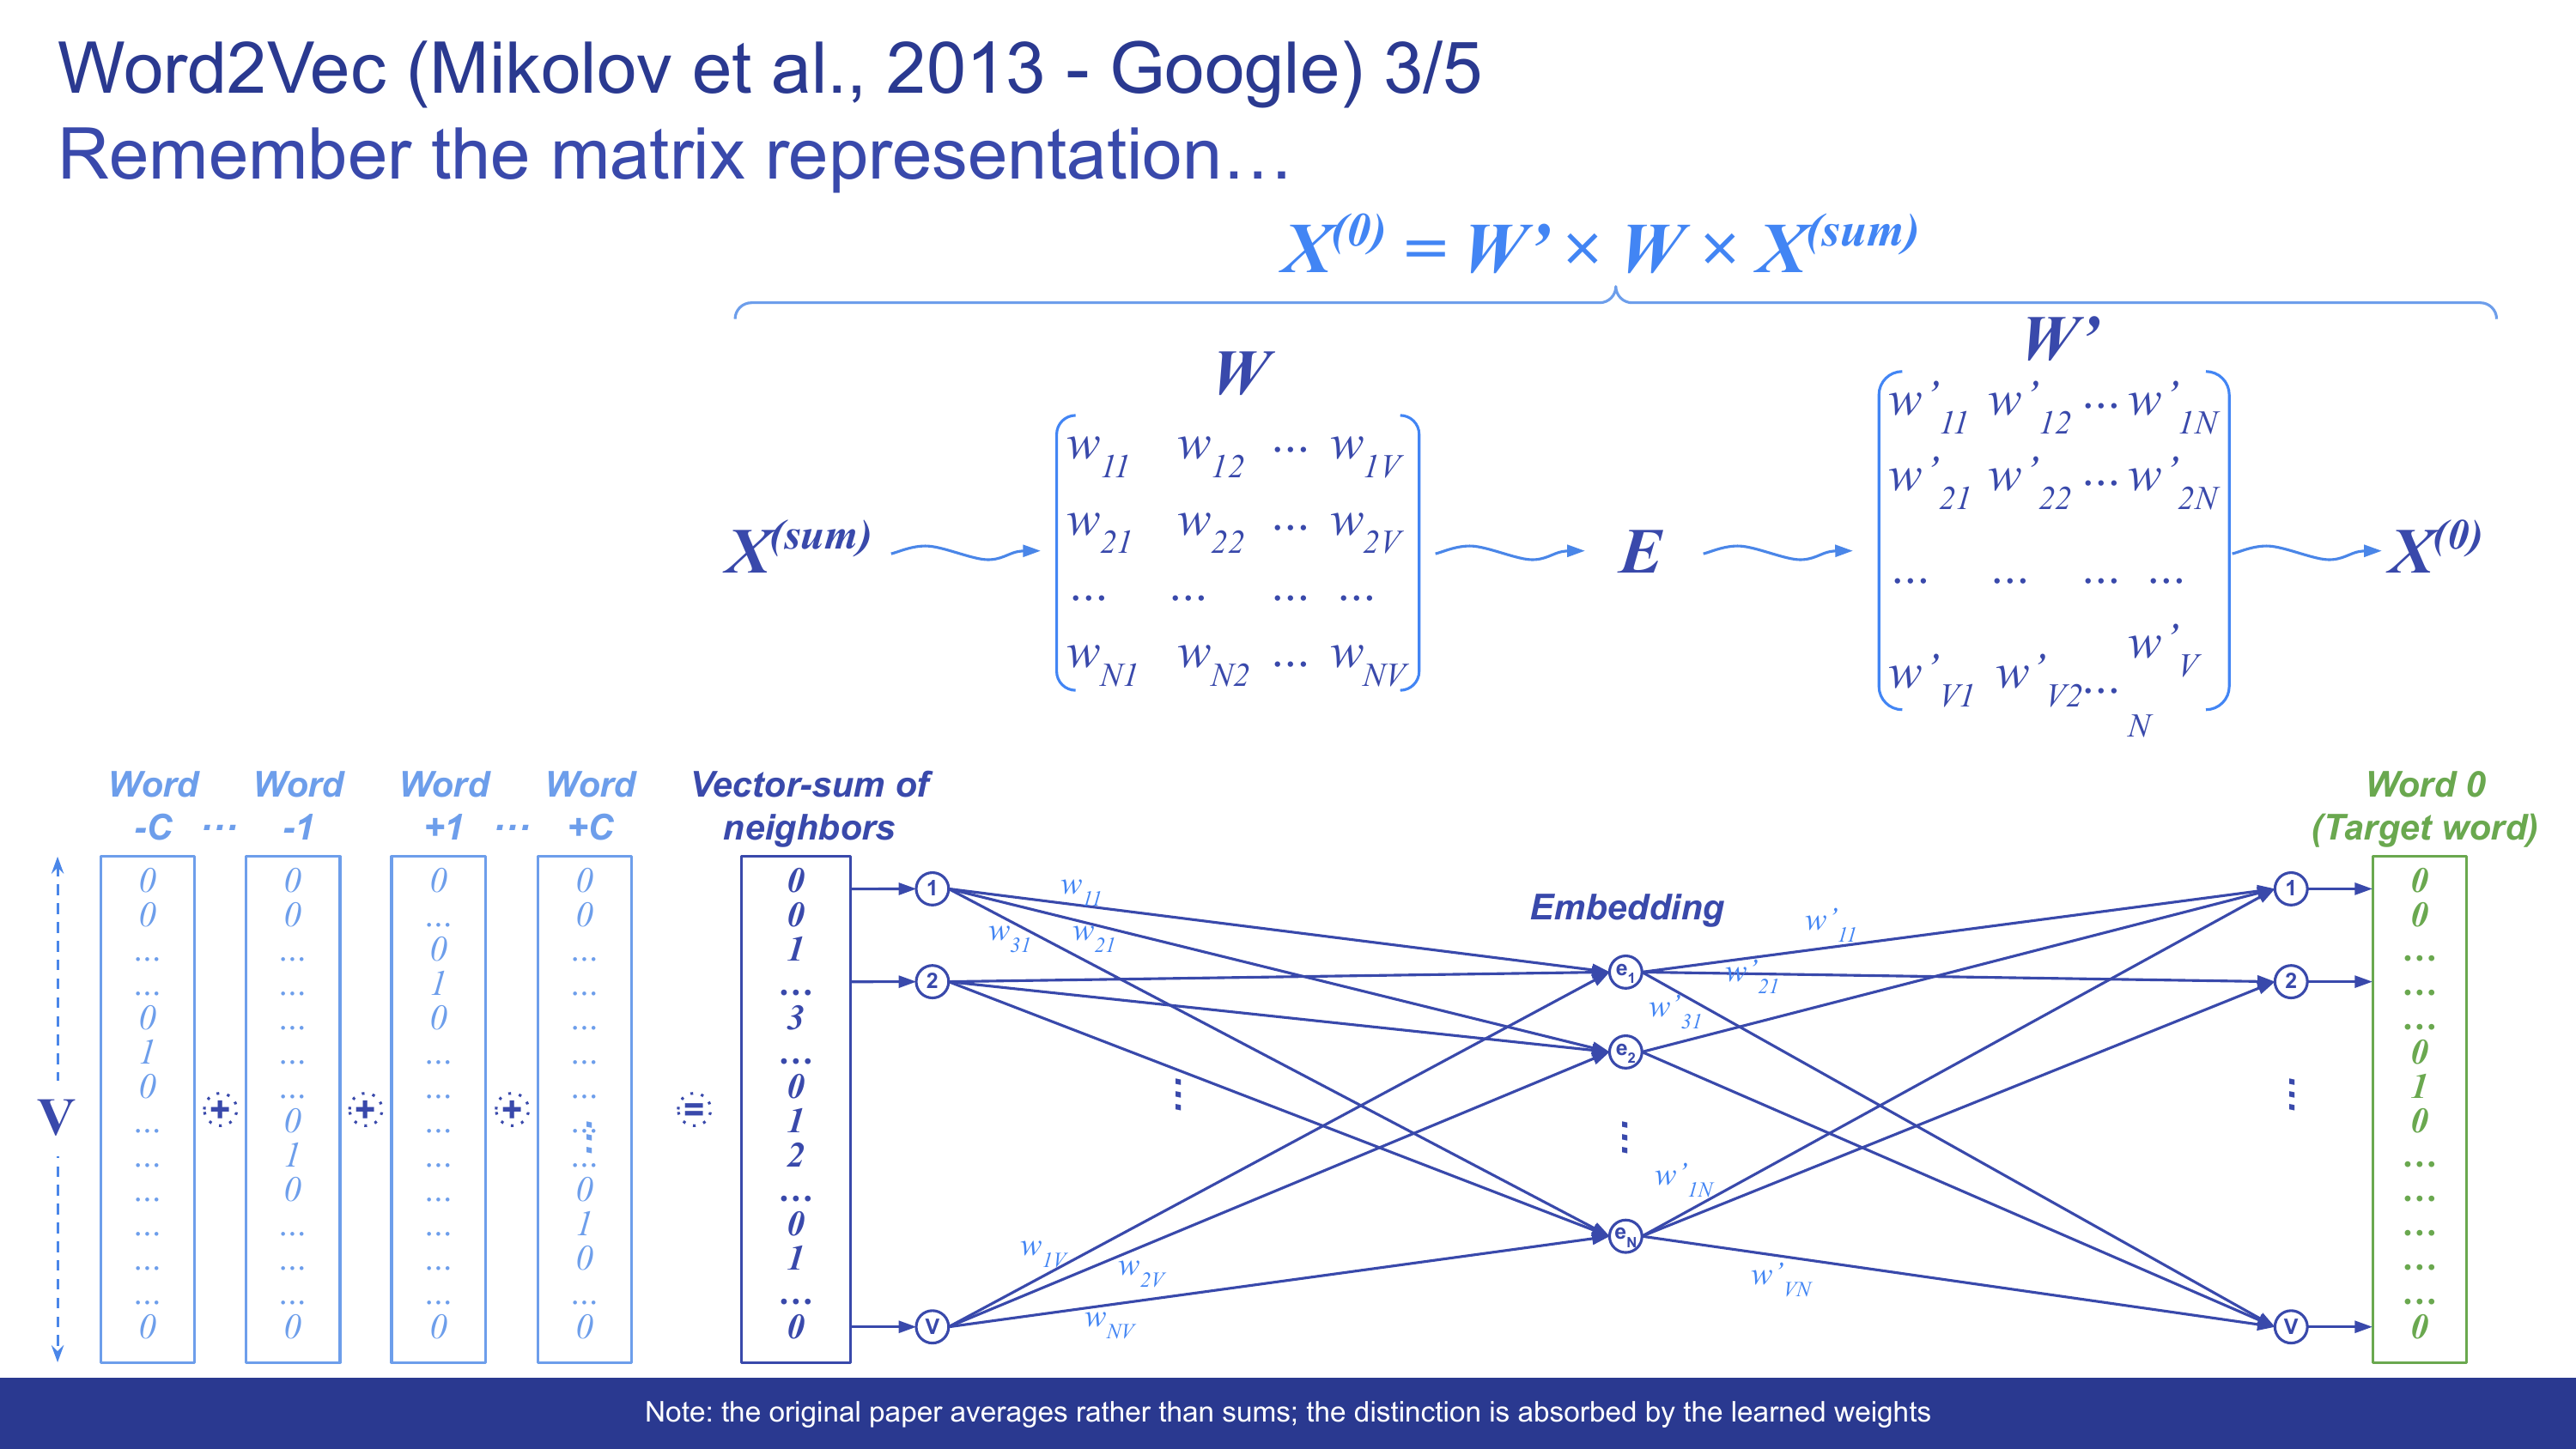
Come nel capitolo 7, conviene scrivere il tutto in forma compatta: X(0) = W’ × W × X(sum). La somma dei vettori di contesto attraversa la matrice W per produrre lo strato nascosto E, poi attraversa la matrice W’ per produrre la predizione X(0). Due moltiplicazioni di matrici, esattamente come nell’esempio a due strati del capitolo 7.
Qui arriva il tocco che rende Word2Vec davvero pratico: non serve nessuna etichettatura umana. Si prende un testo qualsiasi — un romanzo, un articolo, l’intera Wikipedia — e vi si fa scorrere sopra una finestra: ogni posizione della finestra genera da sé una coppia contesto/target. Una frase come In York Abbey, a wooden abacus from the 1700s was discovered produce automaticamente una decina di esempi di addestramento, semplicemente spostando la finestra di una parola alla volta. È lo stesso trucco del pre-training auto-supervisionato che avevamo incontrato nel capitolo 5: il testo grezzo si etichetta da solo.
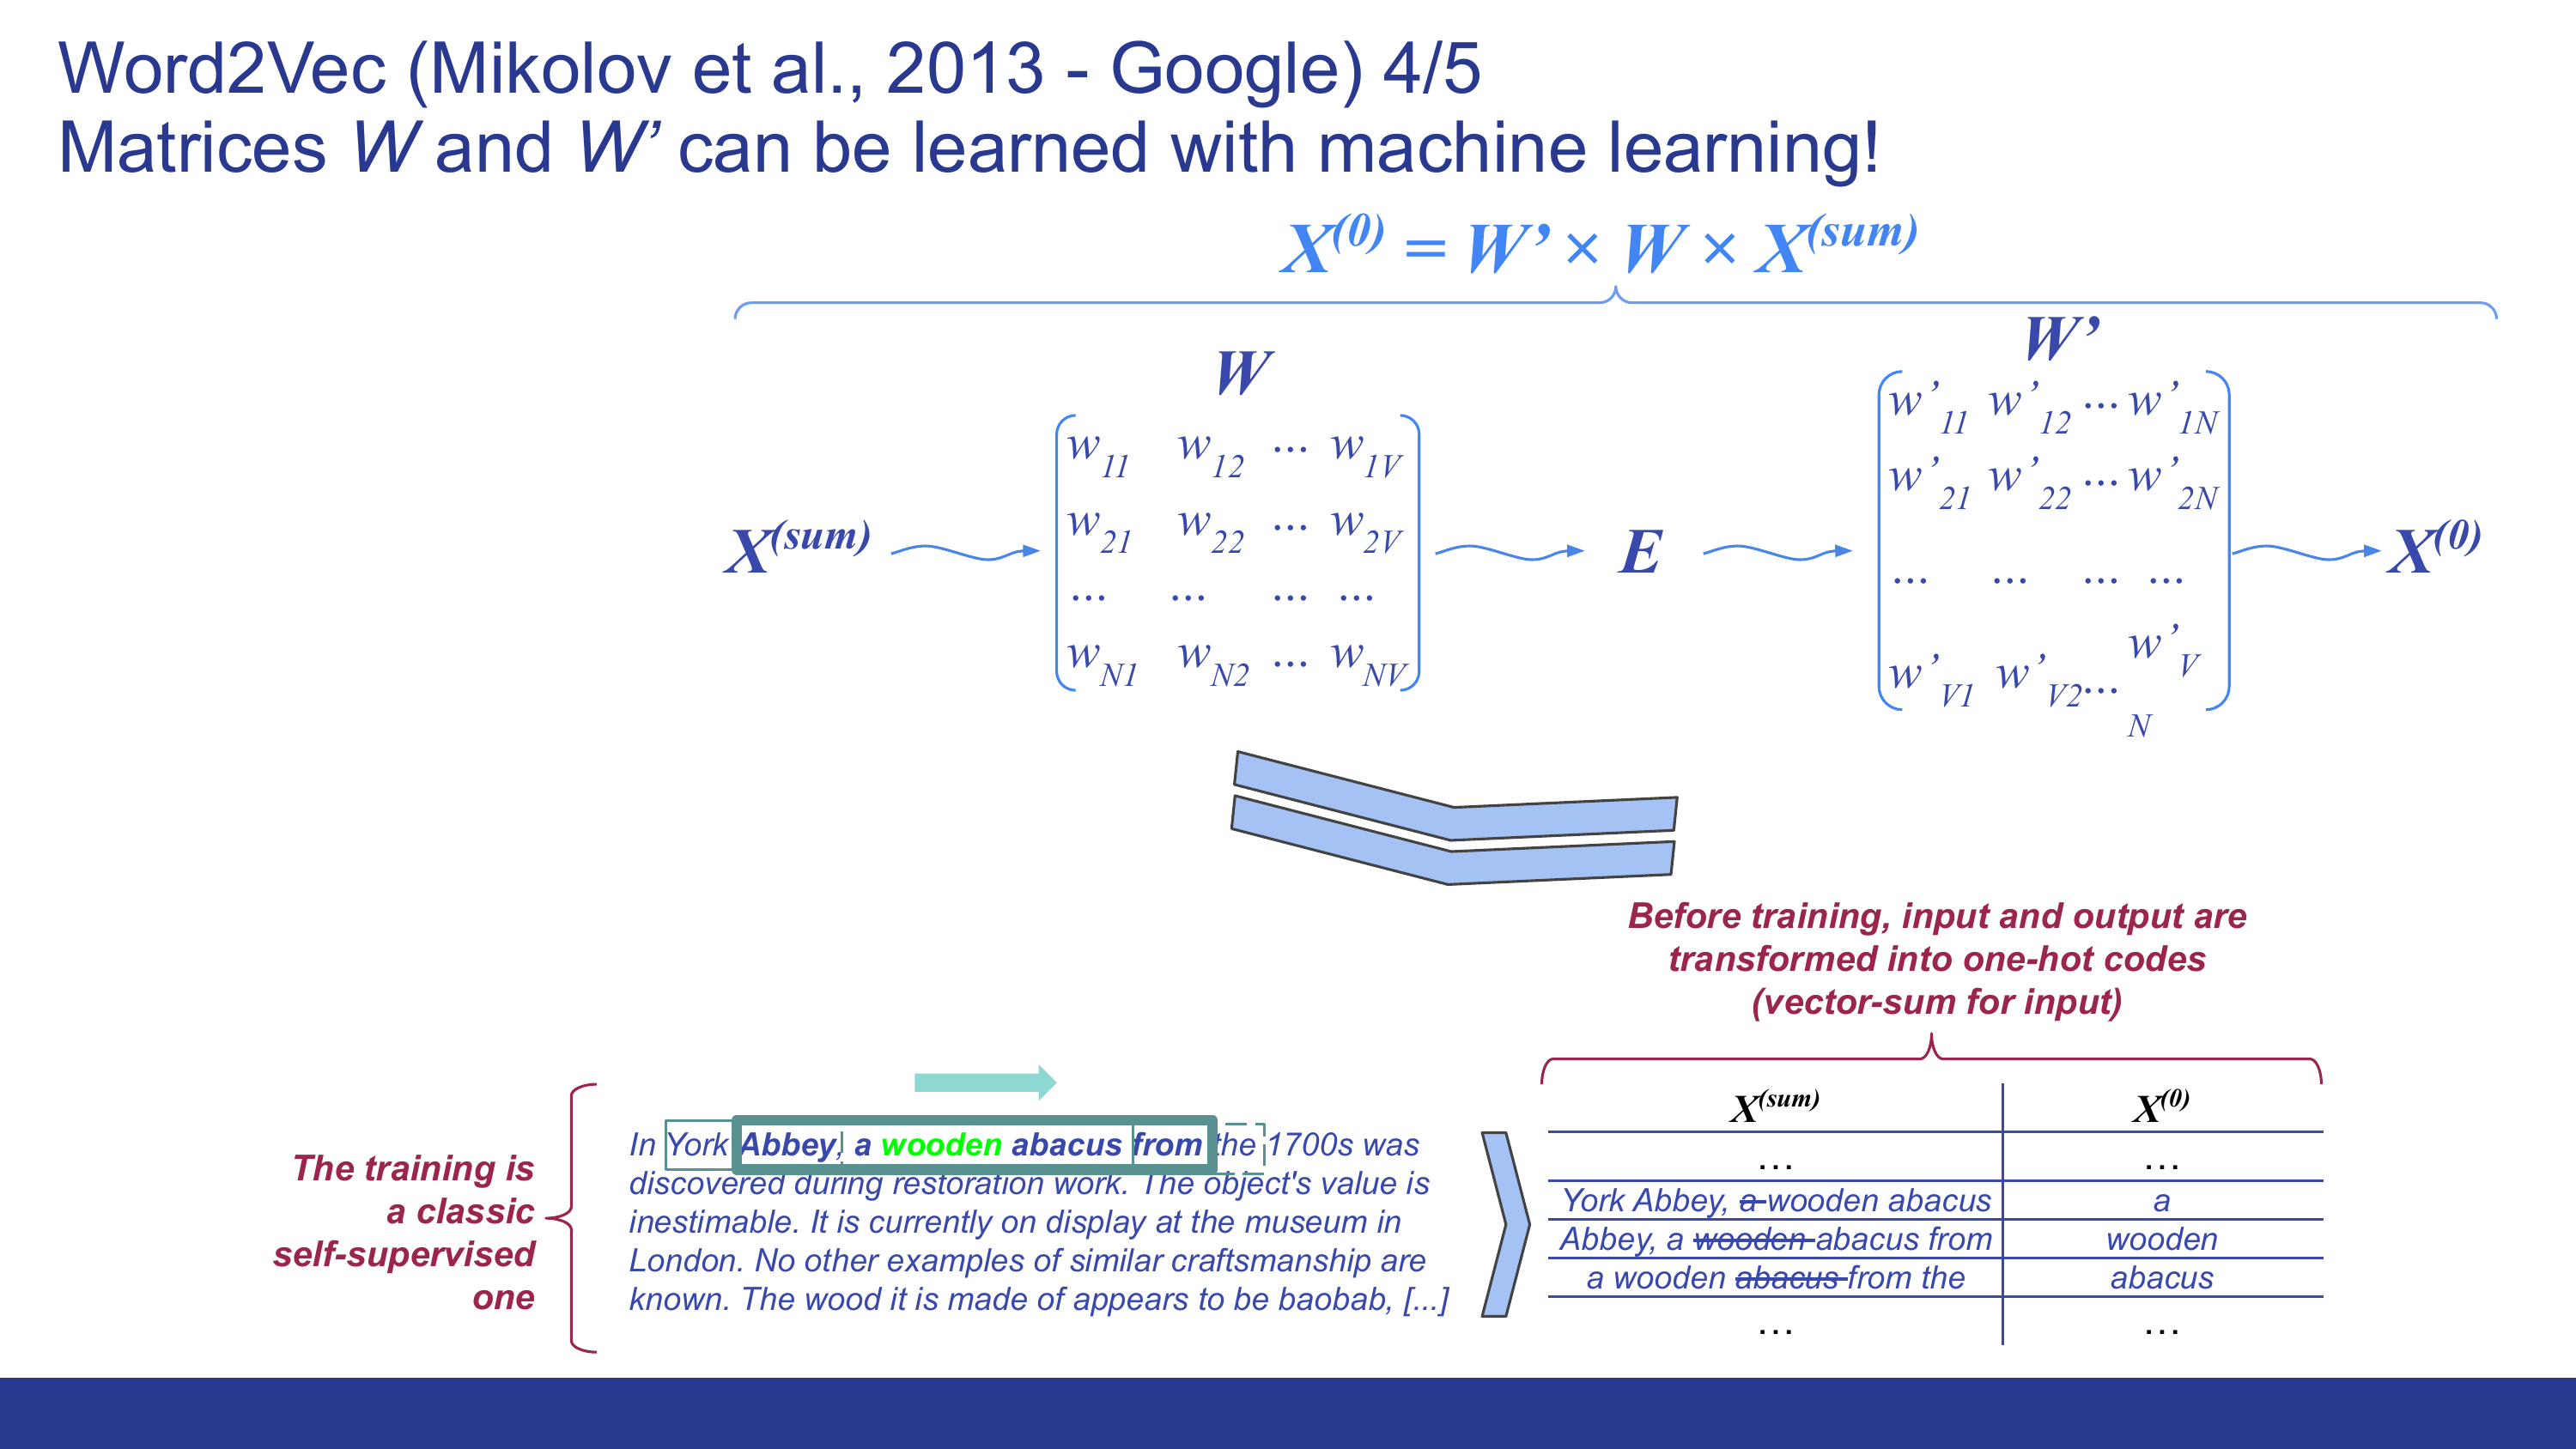
Si addestrano le matrici W e W’ con la normale backpropagation del capitolo 8, minimizzando l’errore di predizione della parola target su milioni di esempi. Ma il vero risultato di tutto questo lavoro non è la predizione in sé, ma un sottoprodotto del processo. Una volta terminato l’addestramento, la colonna i della matrice W è esattamente il vettore di embedding della parola i-esima del vocabolario. Lo strato nascosto, quello che avevamo chiamato E, altro non è che lo spazio denso che cercavamo fin dal capitolo 11 — e il significato delle sue dimensioni non lo ha scelto nessuno: lo ha trovato l’addestramento da solo, guardando in quali contesti compare ciascuna parola, e non è detto che sia un significato umanamente comprensibile.
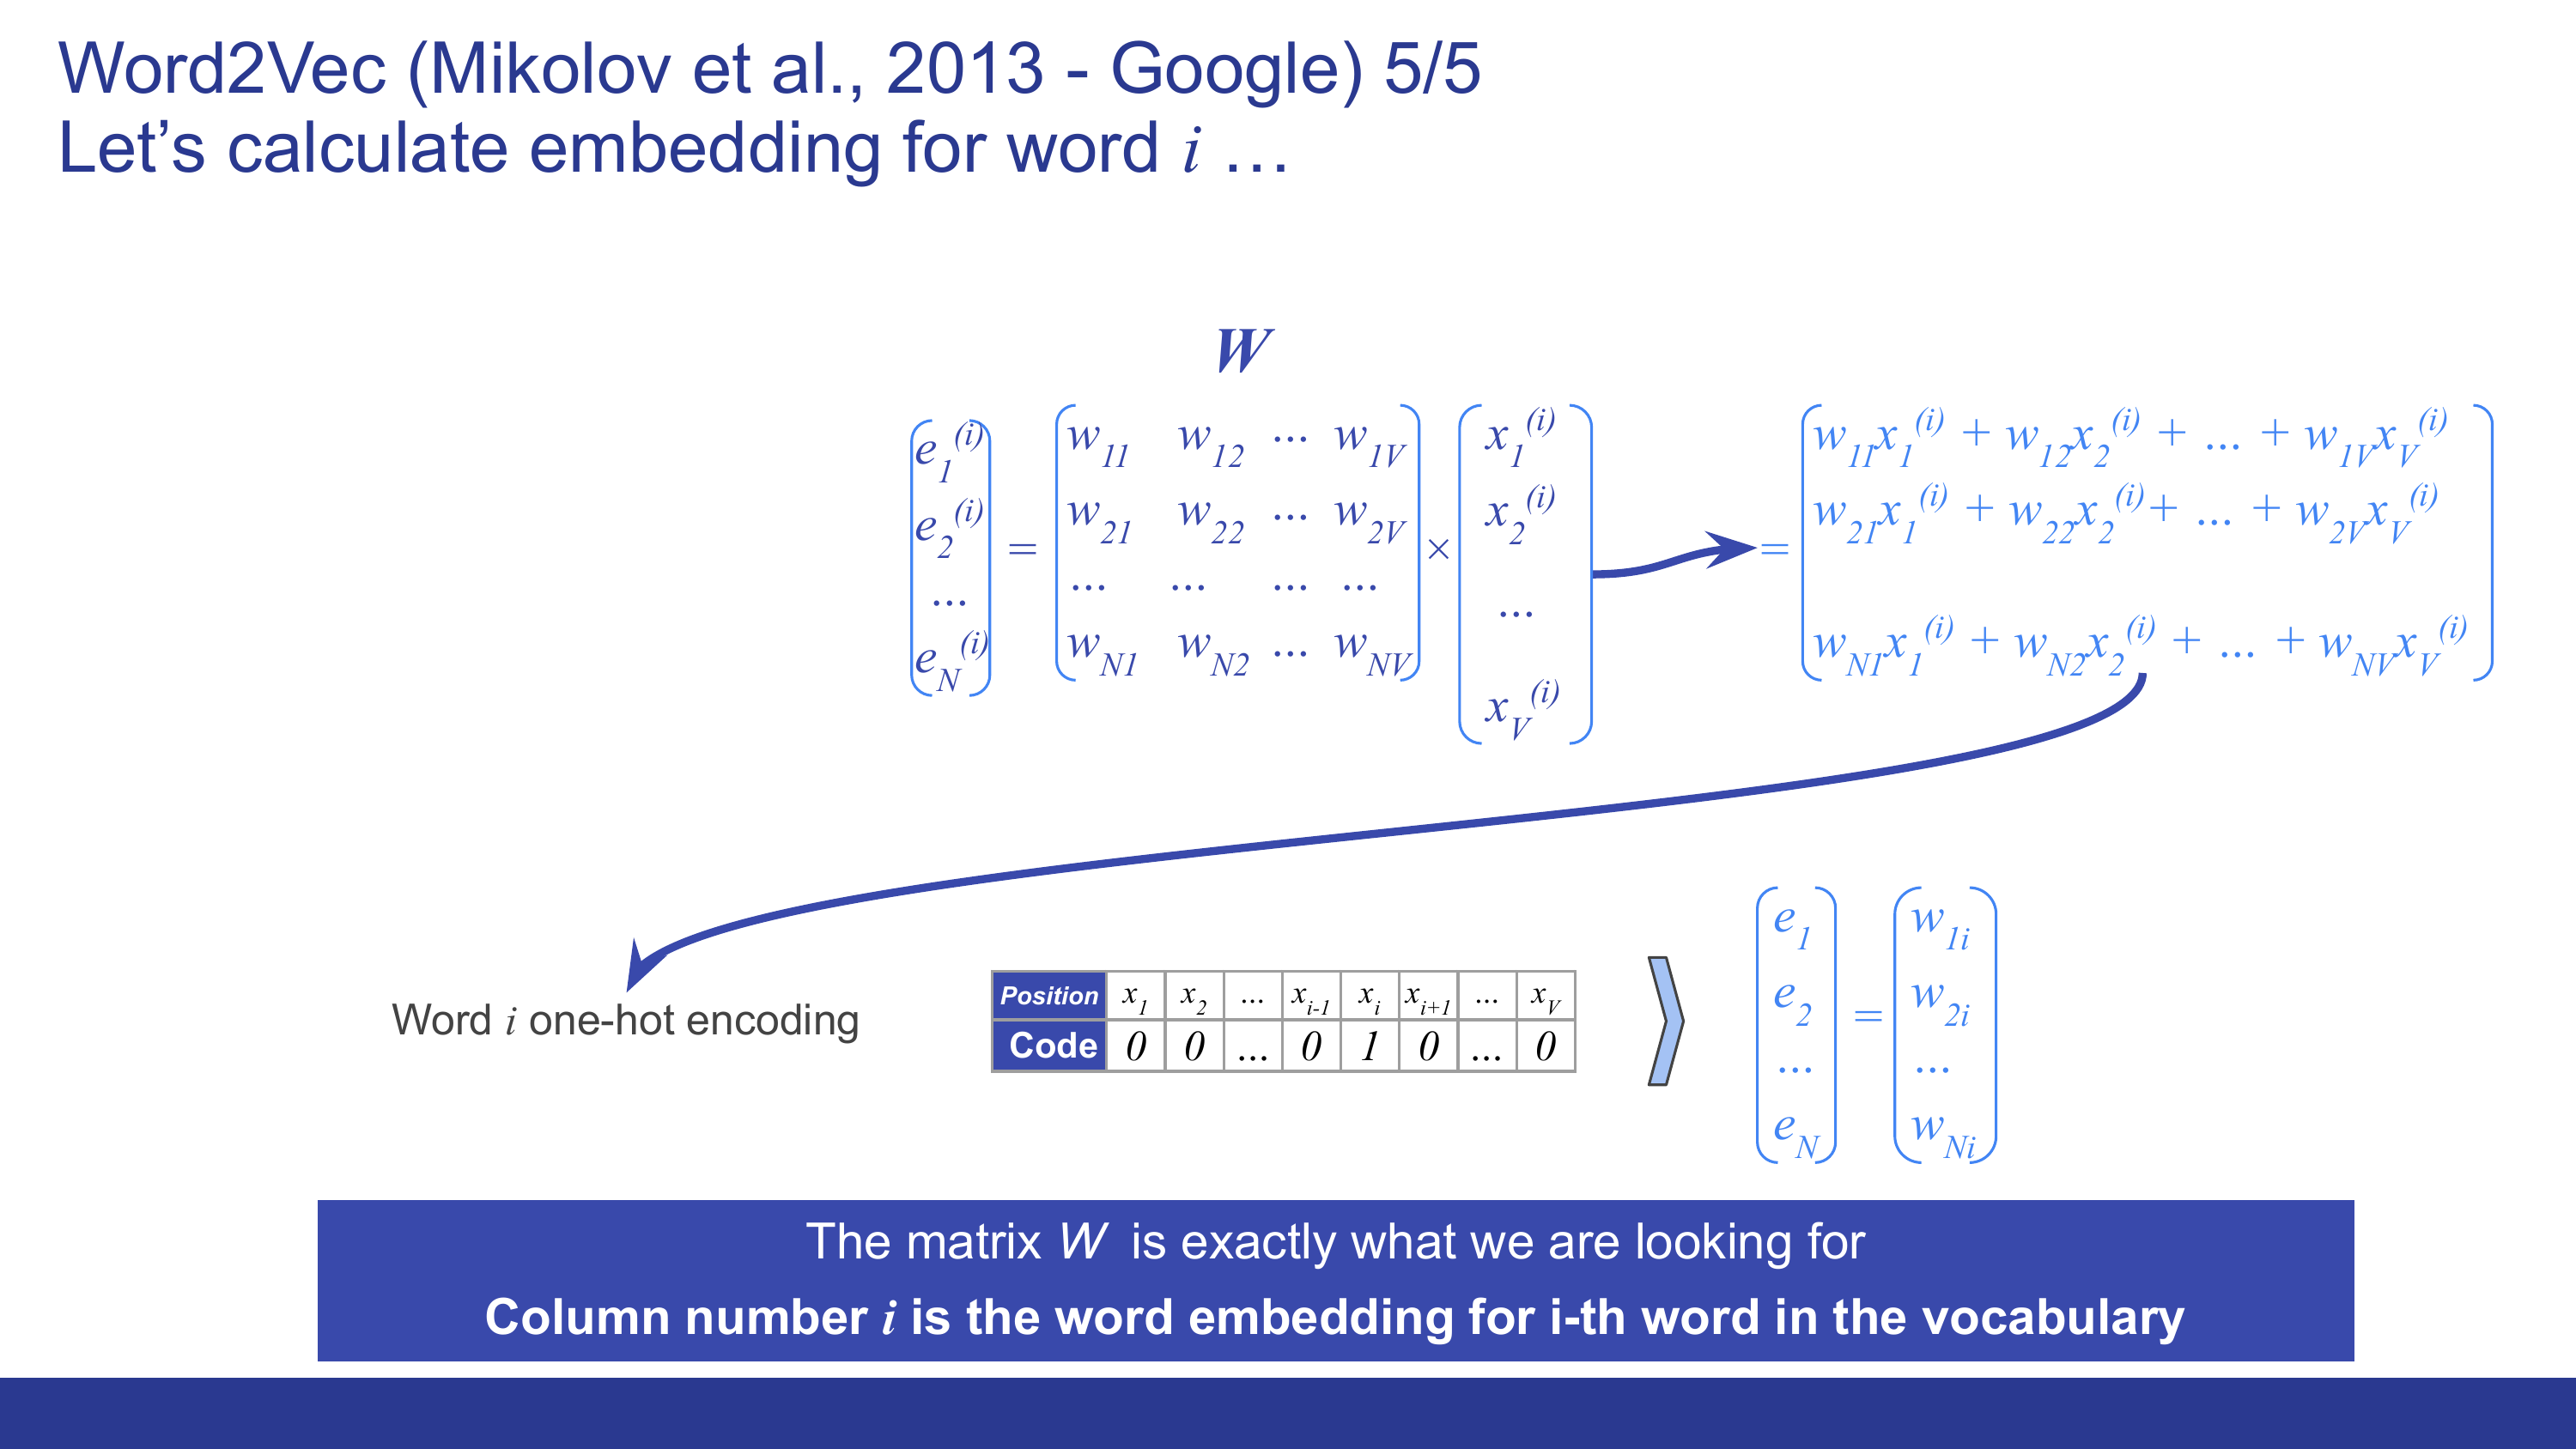
Una rappresentazione vettoriale ottenuta in questo modo realizza esattamente ciò che ci eravamo proposti fin dal capitolo 11: uno spazio in cui la vicinanza di significato — qui, tra una parola e le parole che le stanno intorno — si traduce in vicinanza geometrica. Questi spazi, però, nascondono anche proprietà e limiti inaspettati, che vedremo nel capitolo 13.